
医療画像シミュレーションを加速するGPUレイトレーシング:Apple Silicon向けTOPAS拡張機能
解説対象論文: Hardware ray-traced optical-photon Monte Carlo for radiation detector simulation: a TOPAS extension on Apple Silicon
Physics in Medicine and Biology|被引用数: 0(2026年10月24日時点)
はじめに:医療物理シミュレーションの計算負荷
どうも、Beyond the Pixelです。医療分野における放射線検出器のシミュレーションは、高精度な線量測定やチェレンコフイメージングなどの重要な応用を支えています。しかし、光子モンテカルロシミュレーションでは膨大な数の光子を追跡する必要があり、従来のCPUベースのGeant4では大規模なデータセットの研究が非現実的でした。この課題に対し、Apple Siliconに搭載されたGPUのハードウェアレイトレーシング機能を活用し、TOPASの拡張機能が開発され、シミュレーション速度の大幅な向上が実現しました。本記事では、この革新的な技術について詳しくご紹介します。
革新的なアプローチ:GPUによる光子輸送
放射線医療におけるいくつかの定量的な技術は、線量ではなく光を測定します。その測定信号は、シンチレータ、波長シフター、反射体、レンズ、検出器ウィンドウを透過して生き残った光のフルエンスです。Geant4のG4Op*プロセスセットは、この物理学の基準となる実装を提供していますが、CPU上で1イベントあたり105~106個の光子を輸送するコストがボトルネックとなっていました。これは、幾何学的交差の探索が支配的な要因となっているためです。この課題を解決するため、著者らはApple Silicon向けにハードウェアレイトレーシングによる光子輸送拡張機能を開発しました。このアプローチでは、荷電粒子の輸送と、シンチレーションおよびチェレンコフ光子の生成量計算はCPU上のGeant4に残されます。一方、光子の生成、伝播、およびスコアリングはGPU上で実行されます。GPUは、そのレイトレーシングハードウェアを使用して境界を見つけるか、曲面に関しては表面方程式を解くことで境界を特定します。これにより、光子モンテカルロシミュレーションの主要な計算コストであったジオメトリ交差探索が大幅に加速されます。光学プロセス自体はGeant4の対応するプロセスと同一であり、誘電体-誘電体間の境界物理学は代数的に同一です。この拡張機能は、Apple M3 Ultra(80コアGPU、30スレッドCPUベースライン)上で、光学物理、検出器チェーンのタイミング、曲面交差を含む10のベンチマーク(B1~B10)を用いて詳細に検証されました。
驚異的な検証結果と性能向上
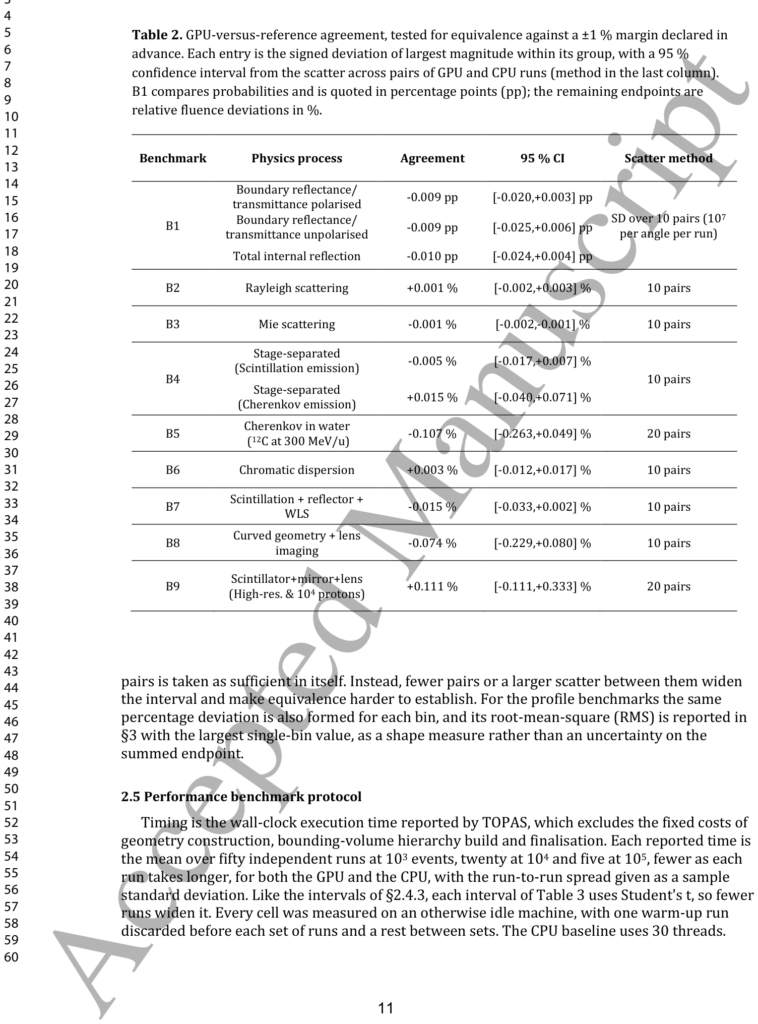
開発された拡張機能は、事前に設定された同等性テストを全ての検証エンドポイントでクリアしました。これは、フルエンスで±1%、反射および透過確率で±1パーセンテージポイントという厳格な許容範囲内での一致を意味します。最大の平均総フルエンス偏差はわずか0.147%であり、全ての総フルエンスの95%信頼区間は±1%以内に収まりました。
特に、シンチレーション-反射体-波長変換のチェーンでは-0.02%の一致、曲面ジオメトリイメージングチェーンでは-0.07%の一致を示しました。また、交差研究では、全体の固体の幾何学的弦長を0.5mmの許容差内で再現することができました。最も顕著な結果は性能面で、整合性のとれたシンチレータ-レンズ-カメラシミュレーションは、実行時間で15.7〜32.0倍、105イベントでのエンドツーエンドでは約24倍高速に実行されました。
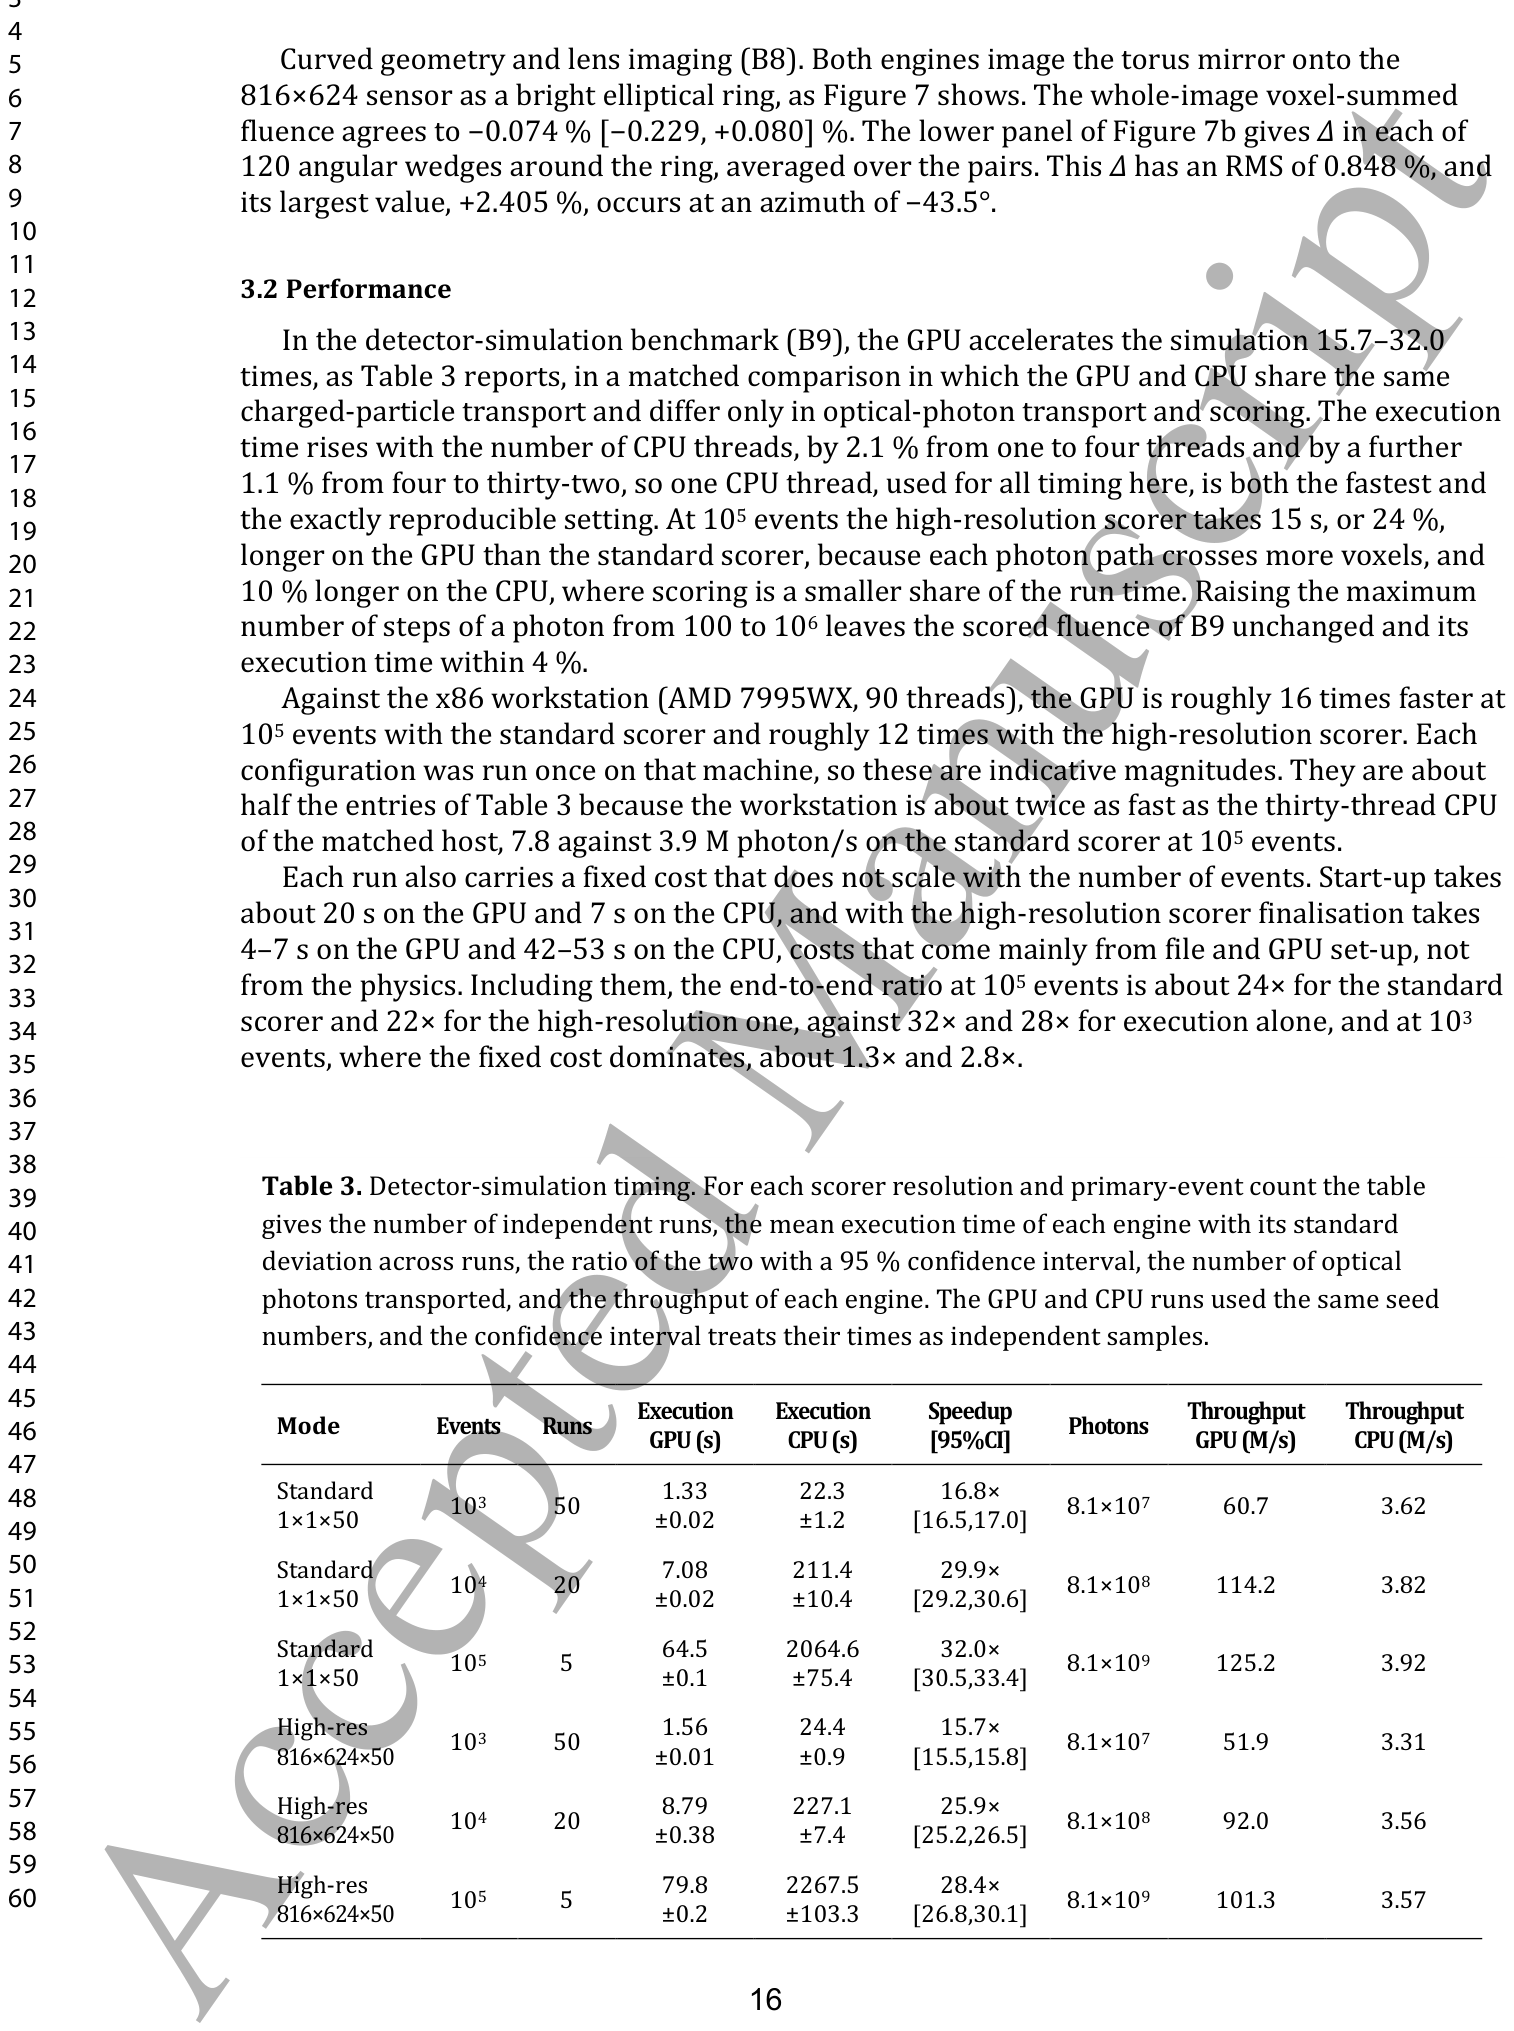
この加速は、C++コードをユーザーが記述することなくTOPASスクリプトがGPU加速の恩恵を受けられることを意味します。これにより、単一のワークステーション上で、シンチレーション線量測定のトレーニングセットやチェレンコフイメージングの順モデルをデータセット規模で生成することが現実的になります。
詳細:ハードウェアと実装の概要
この研究では、GPU実行とCPUリファレンスの両方に単一のApple M3 Ultraが使用されました。このシステムは、GPUとCPUで共有されるユニファイドメモリを備え、800 GB s-1の帯域幅を持ちます。
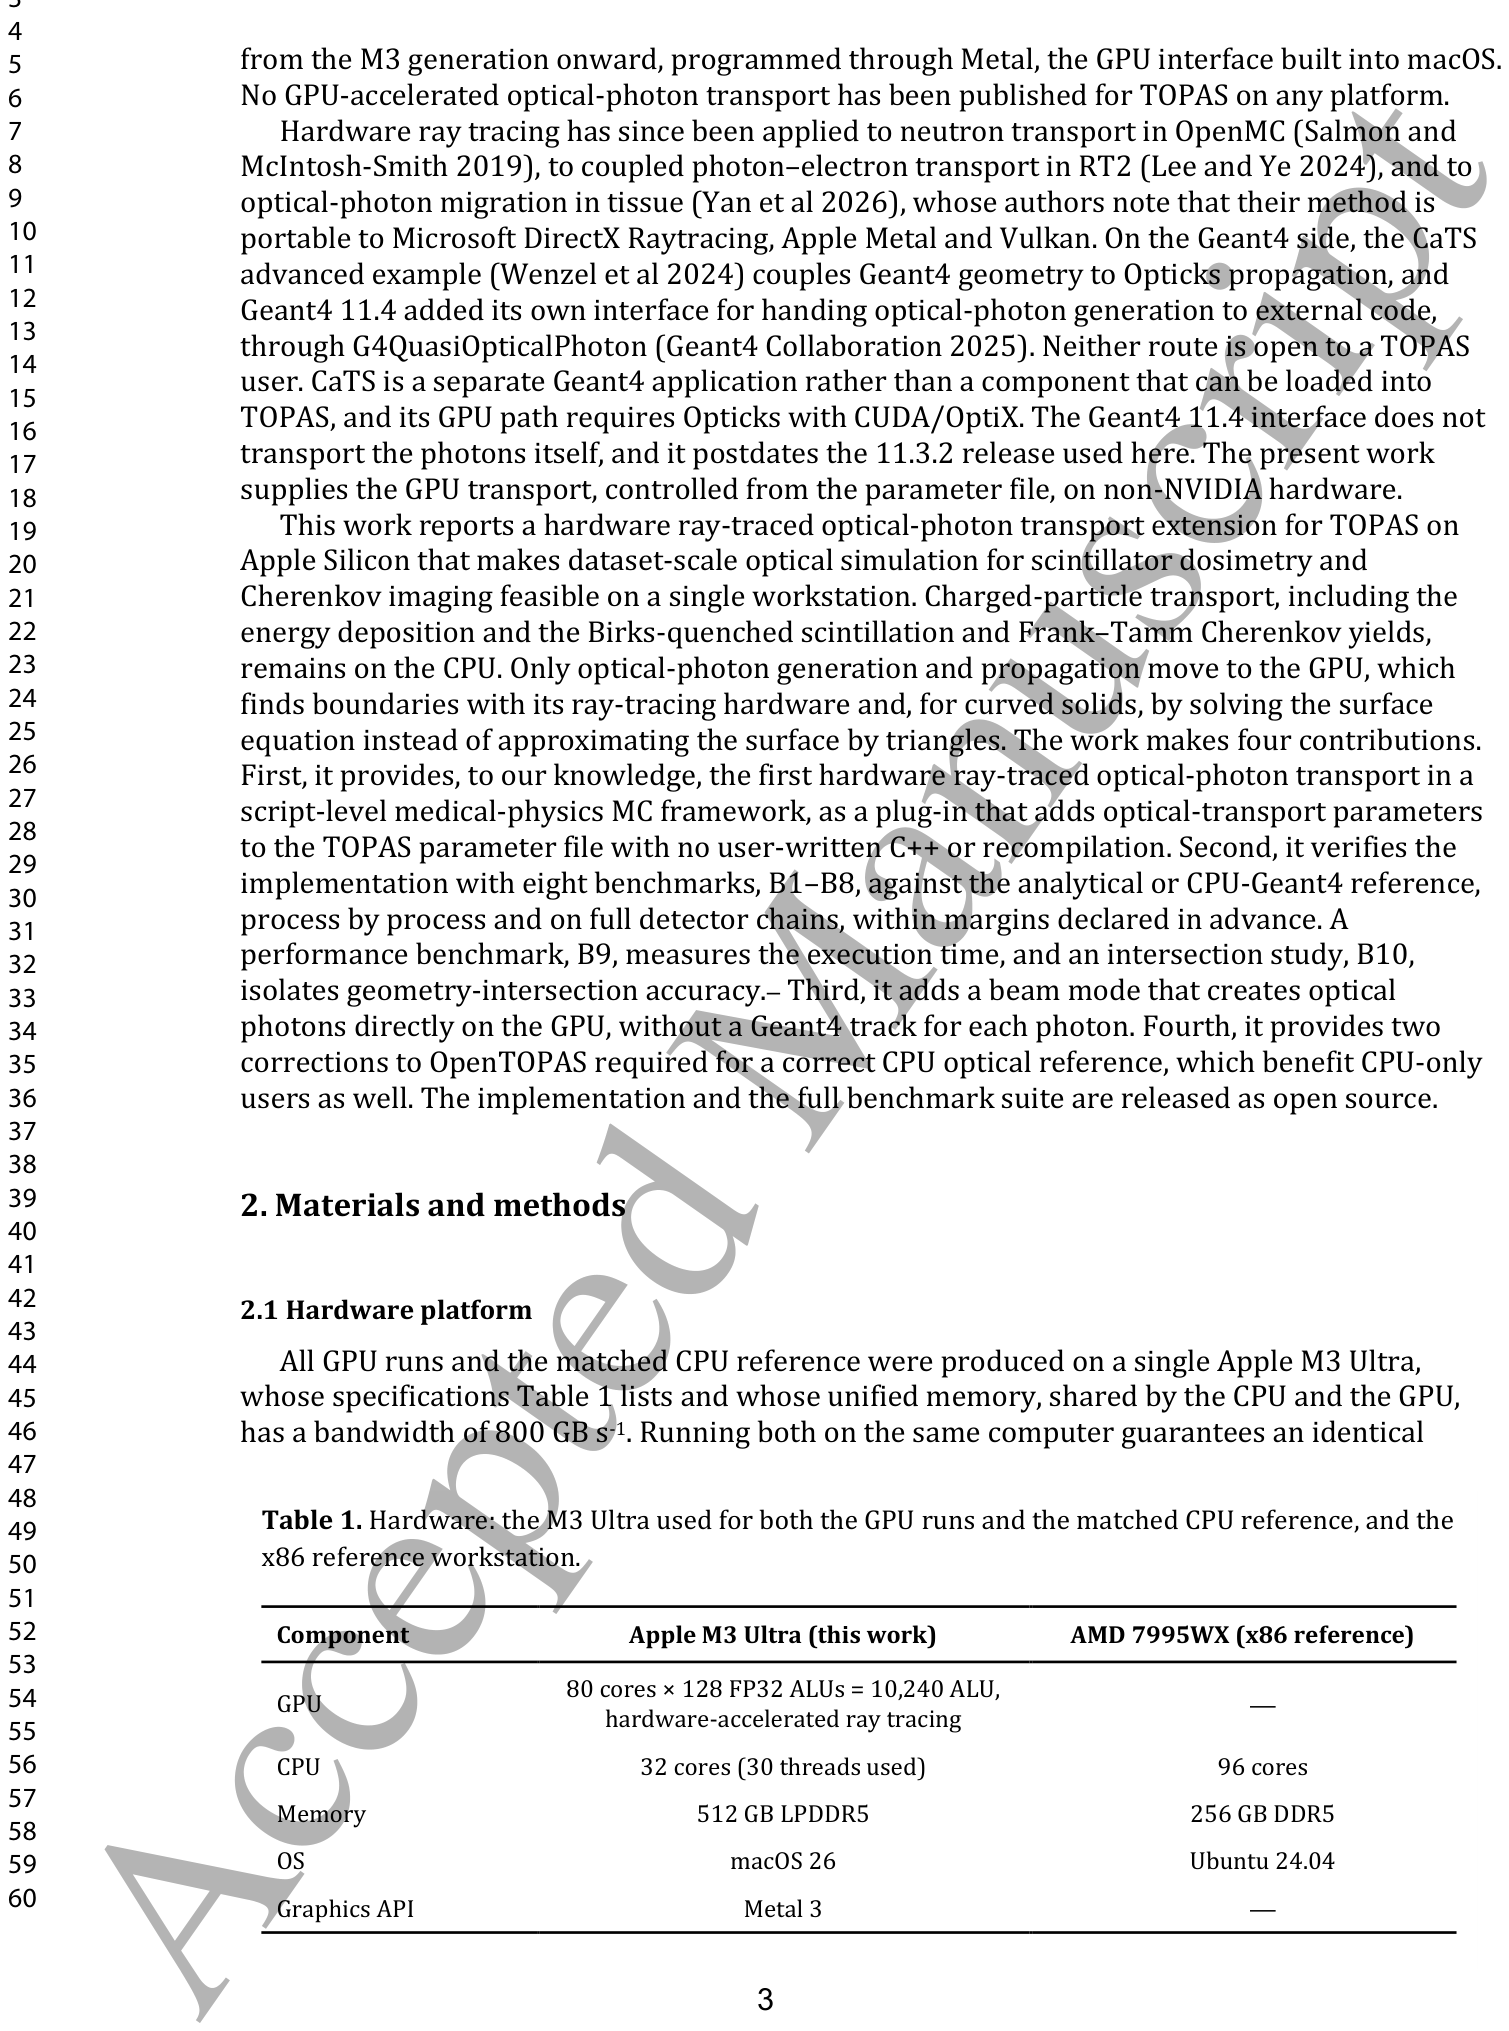
これにより、同じGeant4/TOPASビルド上で両者を実行できる利点があります。
GPU輸送は、OpenTOPAS 4.2.p3のTOPASプラグインとして実装され、Geant4 11.3.2に基づいて構築されています。ユーザーは、標準の電磁気物理リストに加えて、光学物理モジュールとして「gpuoptical」を選択するだけでよく、TOPAS自体は変更されません。実行開始時に、ユーザーのTOPASジオメトリの各ボリュームは三角形メッシュに変換され、GPUはそれを元にバウンディングボリューム階層(レイトレーシングハードウェアが次の表面を探索するために使用する空間インデックス)を構築します。各材料の光学特性(屈折率、群速度、反射率などの表面特性)もGPUにコピーされ、固定グリッド上のルックアップテーブルとして保持されます。
実行中、Geant4はCPU上で荷電粒子を輸送し、光を生成する各ステップで光子数や放出位置などを記録した「genstep(ジェンステップ)」を作成します。これらのgenstepはバッチでGPUに渡され、3つのGPUプログラム(カーネル)が順に実行されます。1つ目のカーネルは各genstepを光子に展開し、2つ目のカーネルは各光子を1つのGPUスレッドで伝播させます。この際、レイトレーシングハードウェアを使用して次の境界を見つけ、光子が吸収されるかジオメトリから出るまで光学物理を適用します。3つ目のカーネルは、光子の経路長をスコアリンググリッドに蓄積します。CPUとGPUは並行して動作し、CPUが次のバッチを準備する間にGPUが現在のバッチを輸送するため、GPUを効率的に利用できます。光子はGPU上で生成・保持されるため、genstepと返されるヒットのみがCPUとGPU間でやり取りされます。
genstepモードに加えて、「ビームモード」も提供されており、ユーザーはレーザーやLEDなどの光学光源を直接定義し、Geant4トラックを介さずにGPU自身が光子を生成することができます。また、この研究では、正しいCPU光子参照のためにOpenTOPASにいくつかの修正が適用されました。これには、光子を輸送するジオメトリ上に重ねられた全てのスコアリングボリュームを1nm内側に縮小する修正や、TOPAS粒子源が非偏光光子に間違った偏光を与える問題を修正するなどが含まれます。
光学物理モデルとジオメトリ交差
この拡張機能では、各光学プロセスについて、物理モデル、GPUカーネルのサンプリングルール、再現されたGeant4プロセス、および検証に使用されたベンチマークが明確に示されています。
光子生成:シンチレーションとチェレンコフ
シンチレーションでは、Birksクエンチングを考慮した平均光子数をCPUで計算した後、GPUが光子の放出位置、方向、波長、偏光をサンプリングします。チェレンコフ放出では、Frank-Tamm関係とG4Cerenkovの平均収量式に基づいて、ステップあたりの光子数とスペクトルを評価し、GPUが光子の放出を行います。シンチレーション生成はB7とB9で、チェレンコフ生成と輸送はB5で検証されました。
バルクプロセス:吸収、レイリー散乱、ミー散乱、波長変換
光子に複数のバルクプロセスが作用する場合、GPUカーネルはGeant4と同様に、各プロセスの平均自由行程から候補となる相互作用長をサンプリングし、最短の相互作用長を持つプロセスを適用します。光子を消滅させる吸収(G4OpAbsorption)は、経路長を指数関数的にサンプリングします。レイリー散乱(G4OpRayleigh)は、波長よりもはるかに小さな密度変動による弾性散乱で、偏光依存のサンプリングを使用します。
ミー散乱(G4OpMieHG)は、波長と同程度の大きさの不均一性による弾性散乱で、Henyey-Greenstein位相関数で表現されます。波長変換(G4OpWLS)は、光子を吸収し、蛍光遅延後に長い波長の光子を再放出します。これらのプロセスは、B2、B3、B5、B7で個別に検証されています。
境界プロセス:フレネル、スネル、全内部反射、UNIFIEDモデル
2つの誘電体間の滑らかな界面では、反射と屈折はフレネル方程式とスネルの法則に従います。GPUは、光子の線形偏光を入射面に垂直(s)および平行(p)な成分に分解し、偏光加重されたフレネル反射率として反射確率を形成します。光子がこの確率に基づいて反射するか屈折するかが決定され、全内部反射も適用されます。この重み付けと再構成はG4OpBoundaryProcess::DielectricDielectricと代数的に同一であり、境界処理が正確であることを示しています。B1では、この境界処理がCPU Geant4に対して検証されました。
粗い表面や研磨された表面、金属裏打ち表面には、UNIFIEDモデルが使用されます。B7、B8、B9で検証されています。
ジオメトリ交差:ハードウェアレイトレーシングと曲面
光学モンテカルロにおける主要な計算コストである次表面探索は、Apple Siliconのレイトレーシングユニットにオフロードされます。これにより、ジオメトリ交差が高速化されます。滑らかな立体を三角形で近似すると、曲面近くの光子経路長に誤差が生じるため、GPUは球体や円柱を解析的に交差計算し、トーラスは数値的に表面方程式を解くことで交差点を特定します。これにより、三角形メッシュ近似によるバイアスが排除されます。交差精度はB10で直接検証されました。中心からオフセットされた光子ビームが吸収性固体を横断し、透過フルエンスから導出される弦長を幾何学的弦長と比較することで、0.5mmの許容差内で一致することが確認されました。
主要ベンチマークの結果
この研究では、8つの検証ベンチマークと2つの付随研究からなるスイートを用いて、実装の厳密な検証が行われました。B1からB8はGeant4との一致をテストし、B9はタイミングプロトコルを定義し、B10は曲面交差精度を定量化しました。全ての検証エンドポイントは、事前に宣言された同等性テストをクリアしました。フルエンスエンドポイントでは±1%以内、B1の境界集計では±1パーセンテージポイント以内でした。
B1(単一界面)
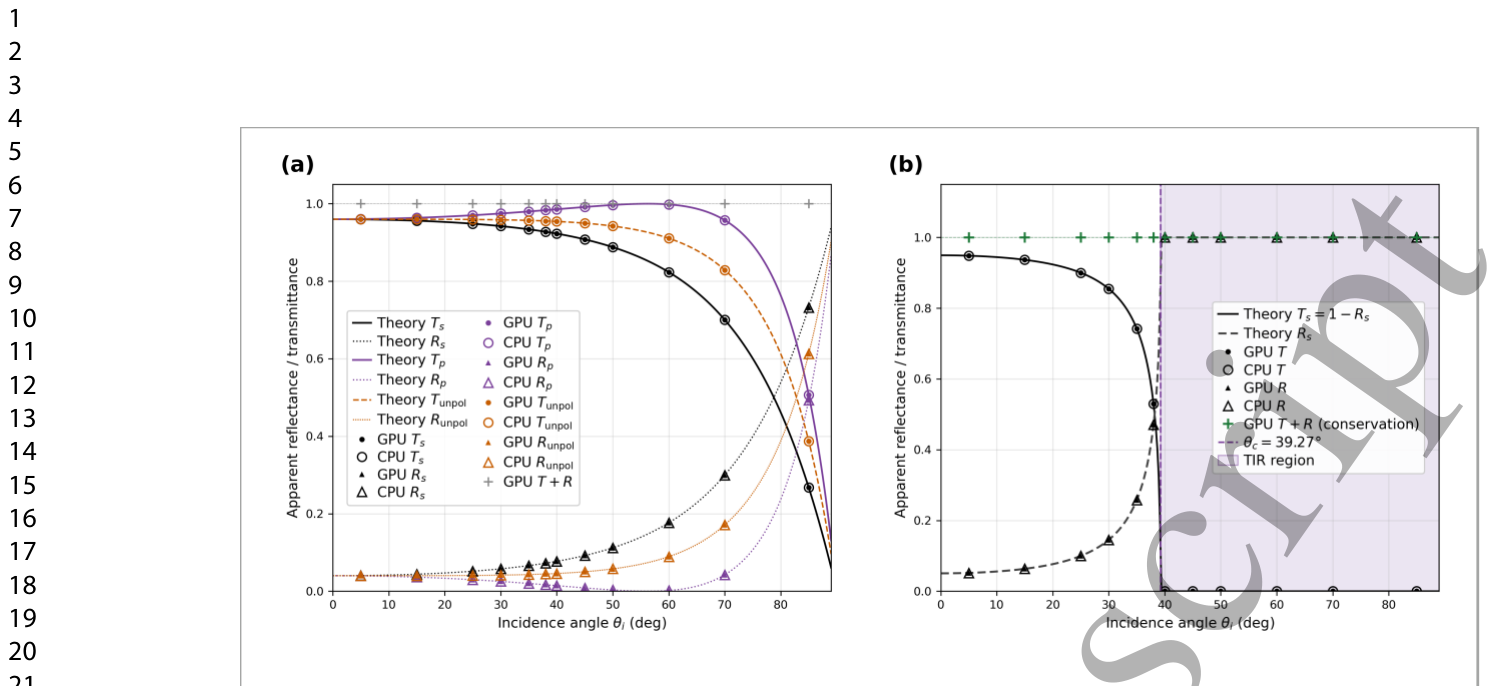
反射、透過、全内部反射の境界ベンチマークでは、反射および透過分率は、走査された全ての角度で解析的なフレネル曲線に従いました。(図1)BC-408/空気遷移では透過率と反射率の合計が1に一致し、光子数の保存が確認されました。最大の平均差は−0.010パーセンテージポイントで、95%信頼区間は±0.025パーセンテージポイント以内に収まりました。
B2(レイリー媒体)とB3(ミー円柱)
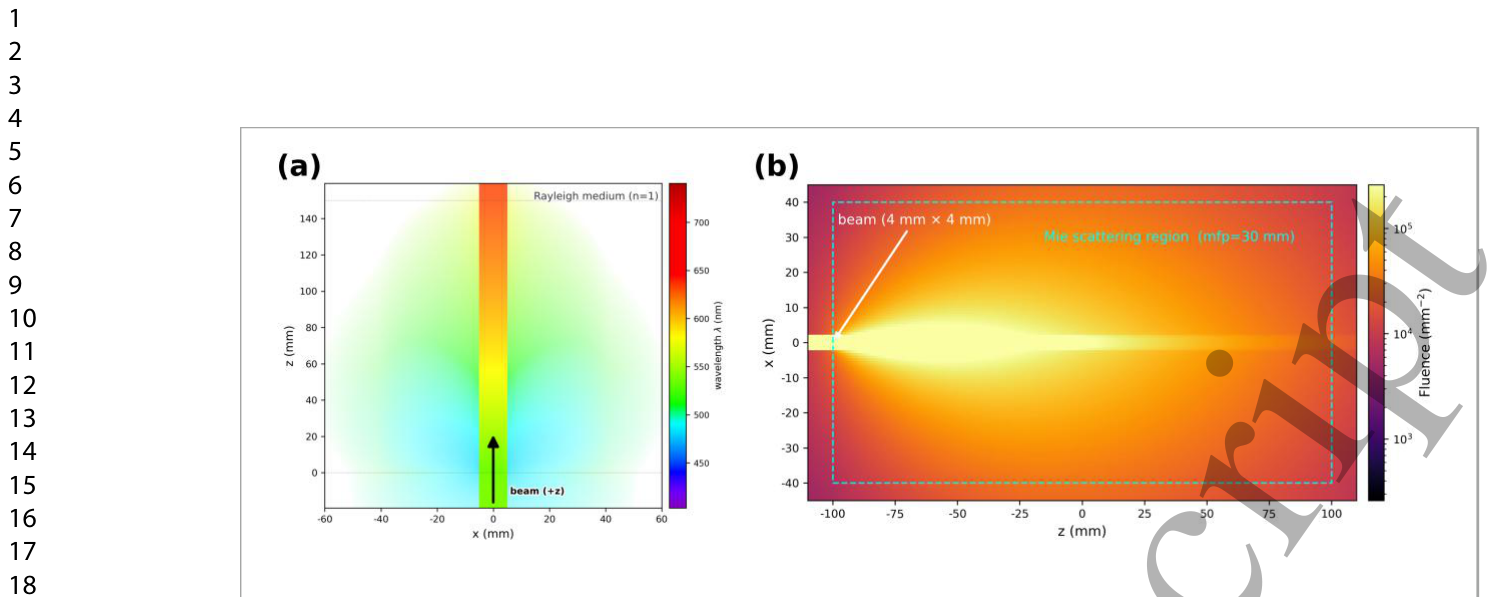
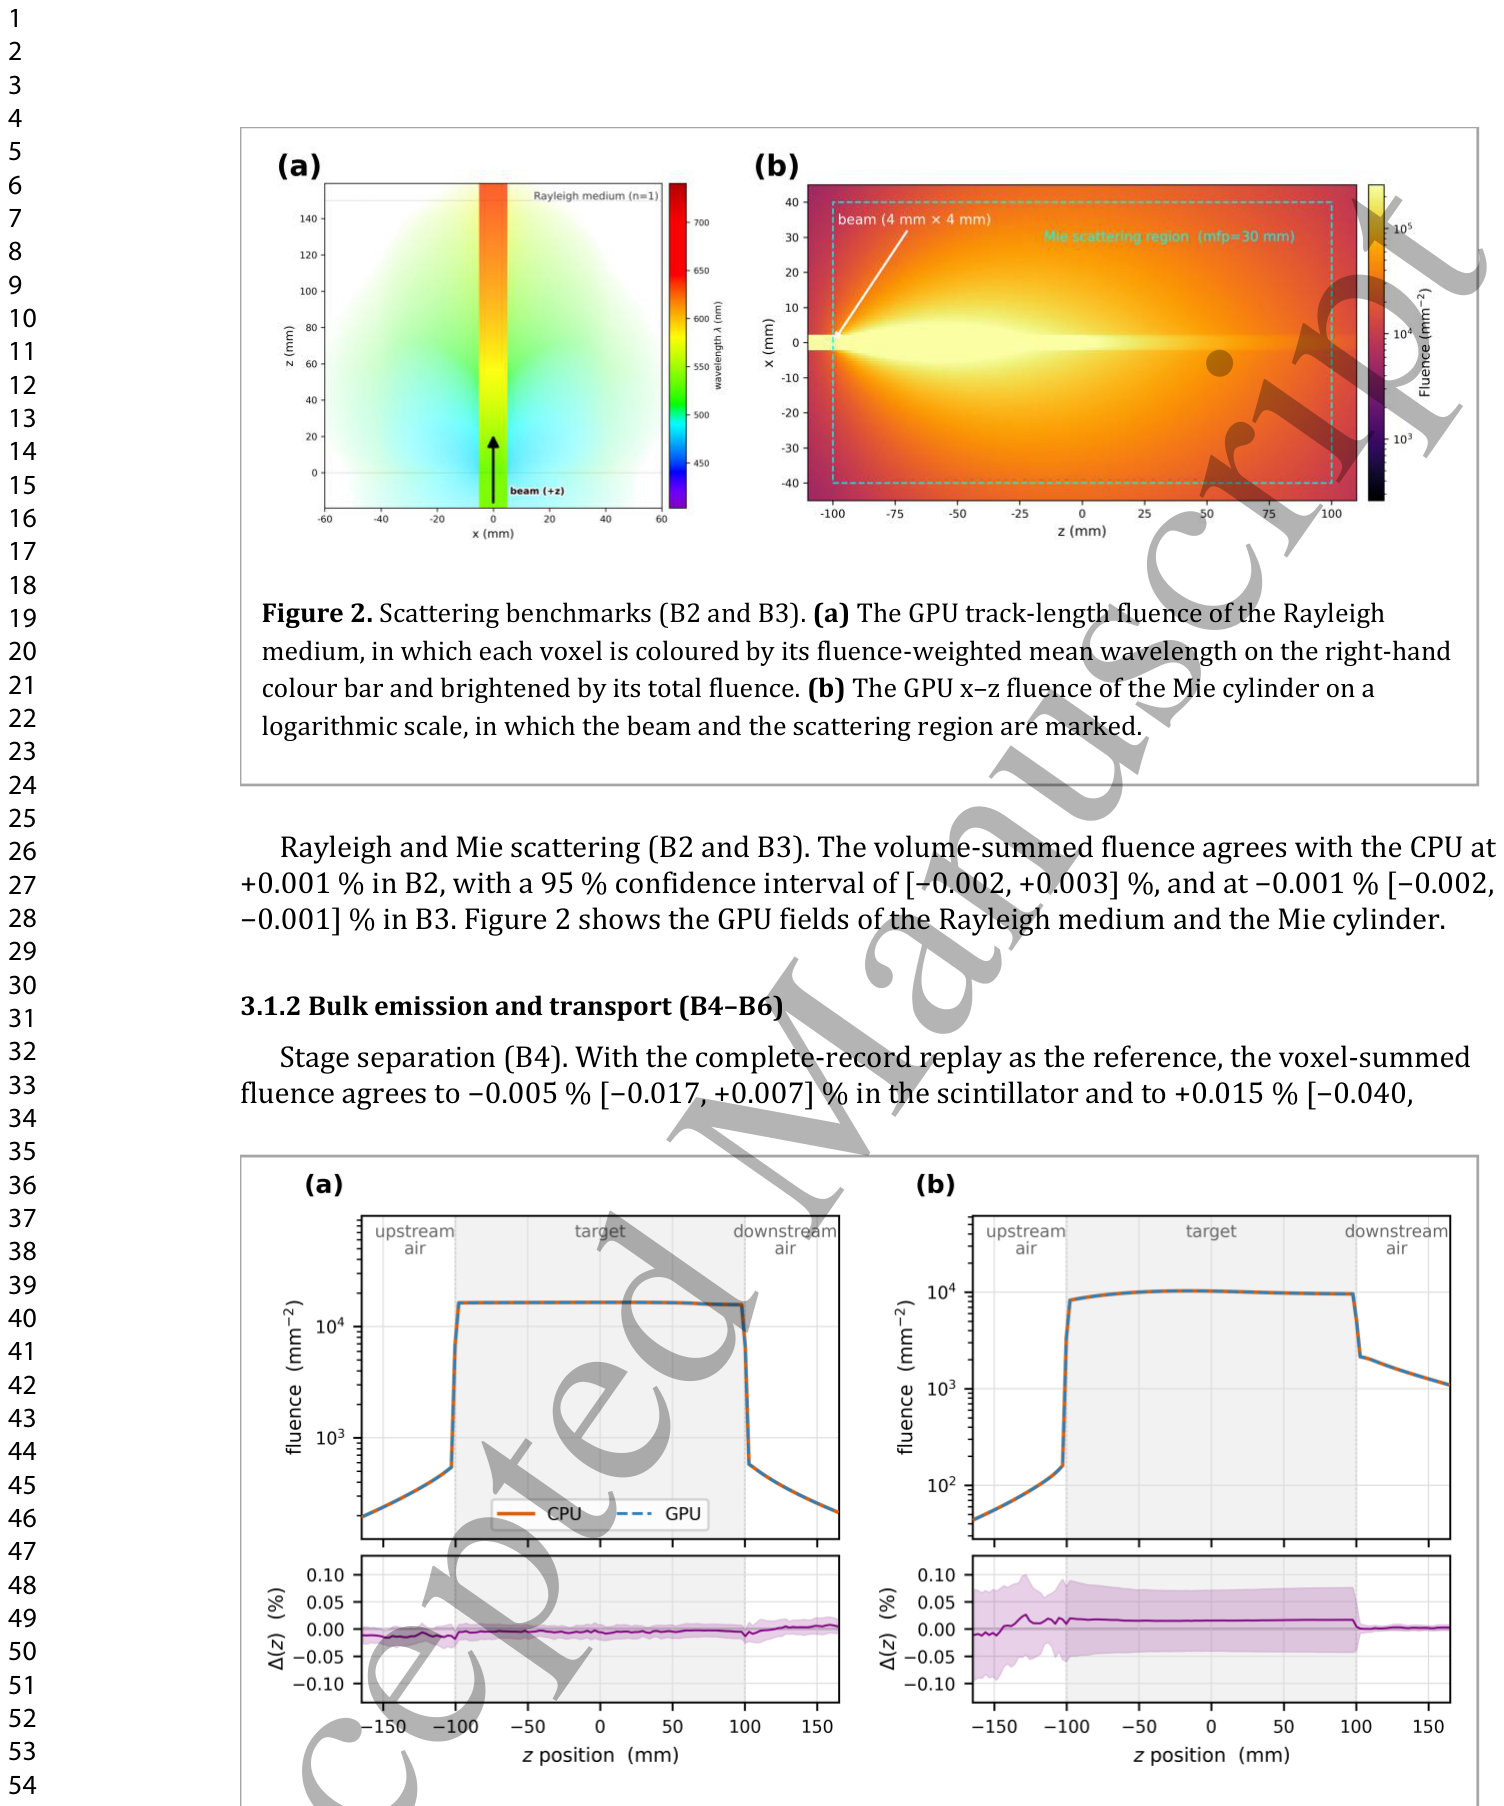
レイリー散乱媒体(B2)の体積合計フルエンスは、CPUと+0.001%で一致し、ミー散乱円柱(B3)では−0.001%で一致しました。(図2)
B4(ステージ分離)
完全な光子記録のリプレイを参照として、シンチレータ中の体積合計フルエンスは−0.005%で、水中では+0.015%で一致しました。
生成された光子数も0.07%以内で一致しました。
B5(水立方体中のチェレンコフ)
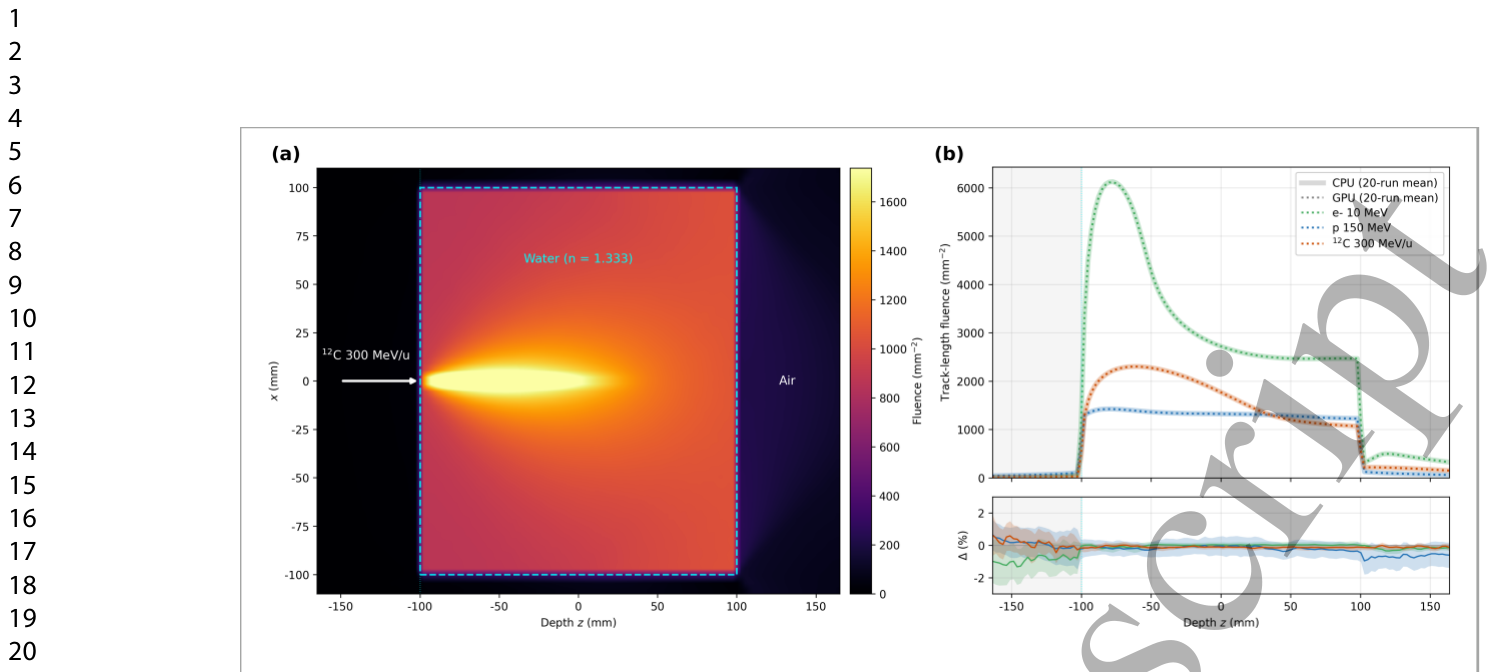
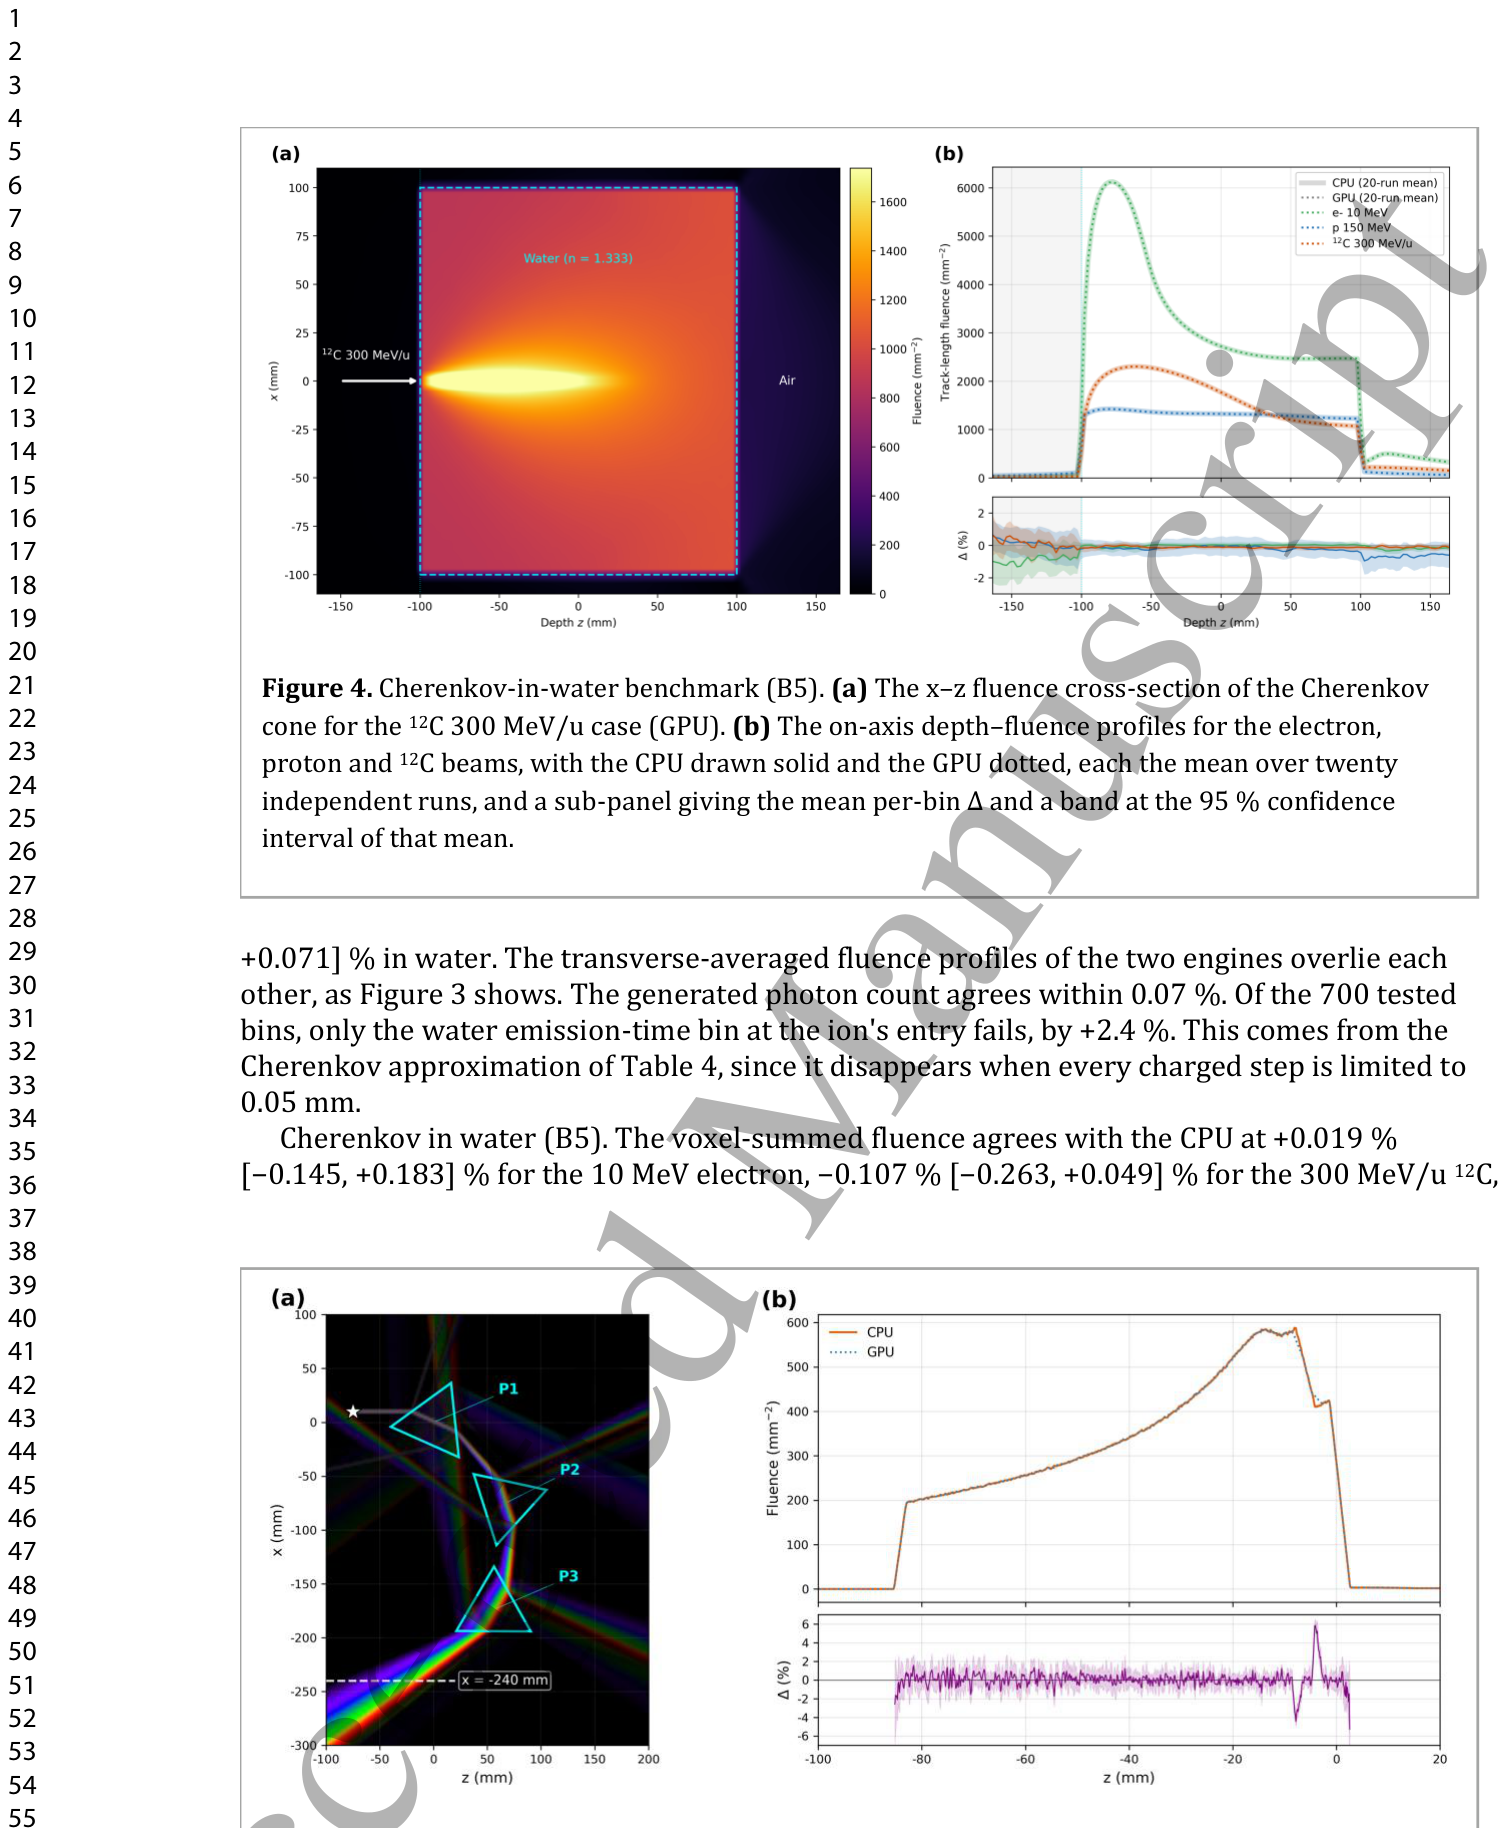
水立方体中のチェレンコフ光子輸送では、10 MeV電子で+0.019%、300 MeV/uの12Cで−0.107%、150 MeV陽子で−0.147%と、体積合計フルエンスがCPUと一致しました。軸に沿った深さプロファイルは、水中では全てのビンで0.38%以内で一致しました。(図4)
B6(色分散プリズムカスケード)
色分散プリズムカスケードでは、体積合計フルエンスが+0.003%で一致しました。zプロファイルでは、一部のビンで最大5.8%の偏差が見られましたが、これはGeant4の屈折率補間の違いに起因するものです。
B7(CsI + 反射体 + WLSチェーン)
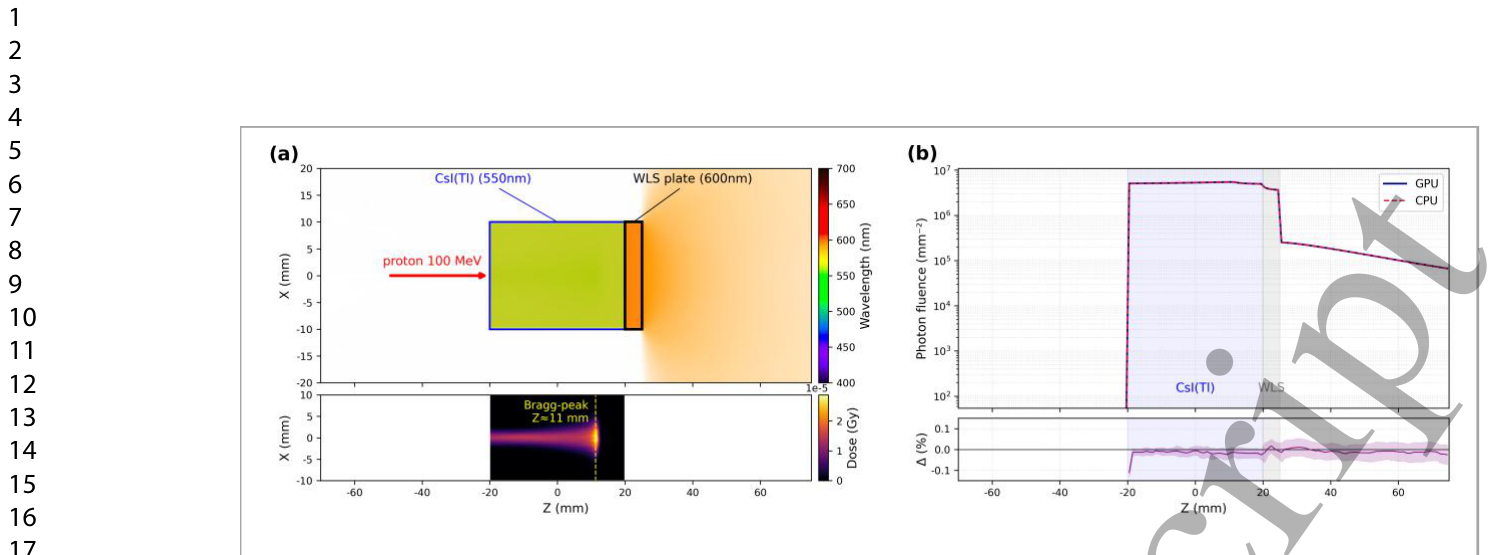
シンチレーション、反射体、波長変換の結合チェーンでは、体積合計フルエンスがCPU Geant4と−0.015%で一致しました。深さプロファイルも高い精度で一致しています。
B8(曲面ジオメトリ + レンズイメージング)
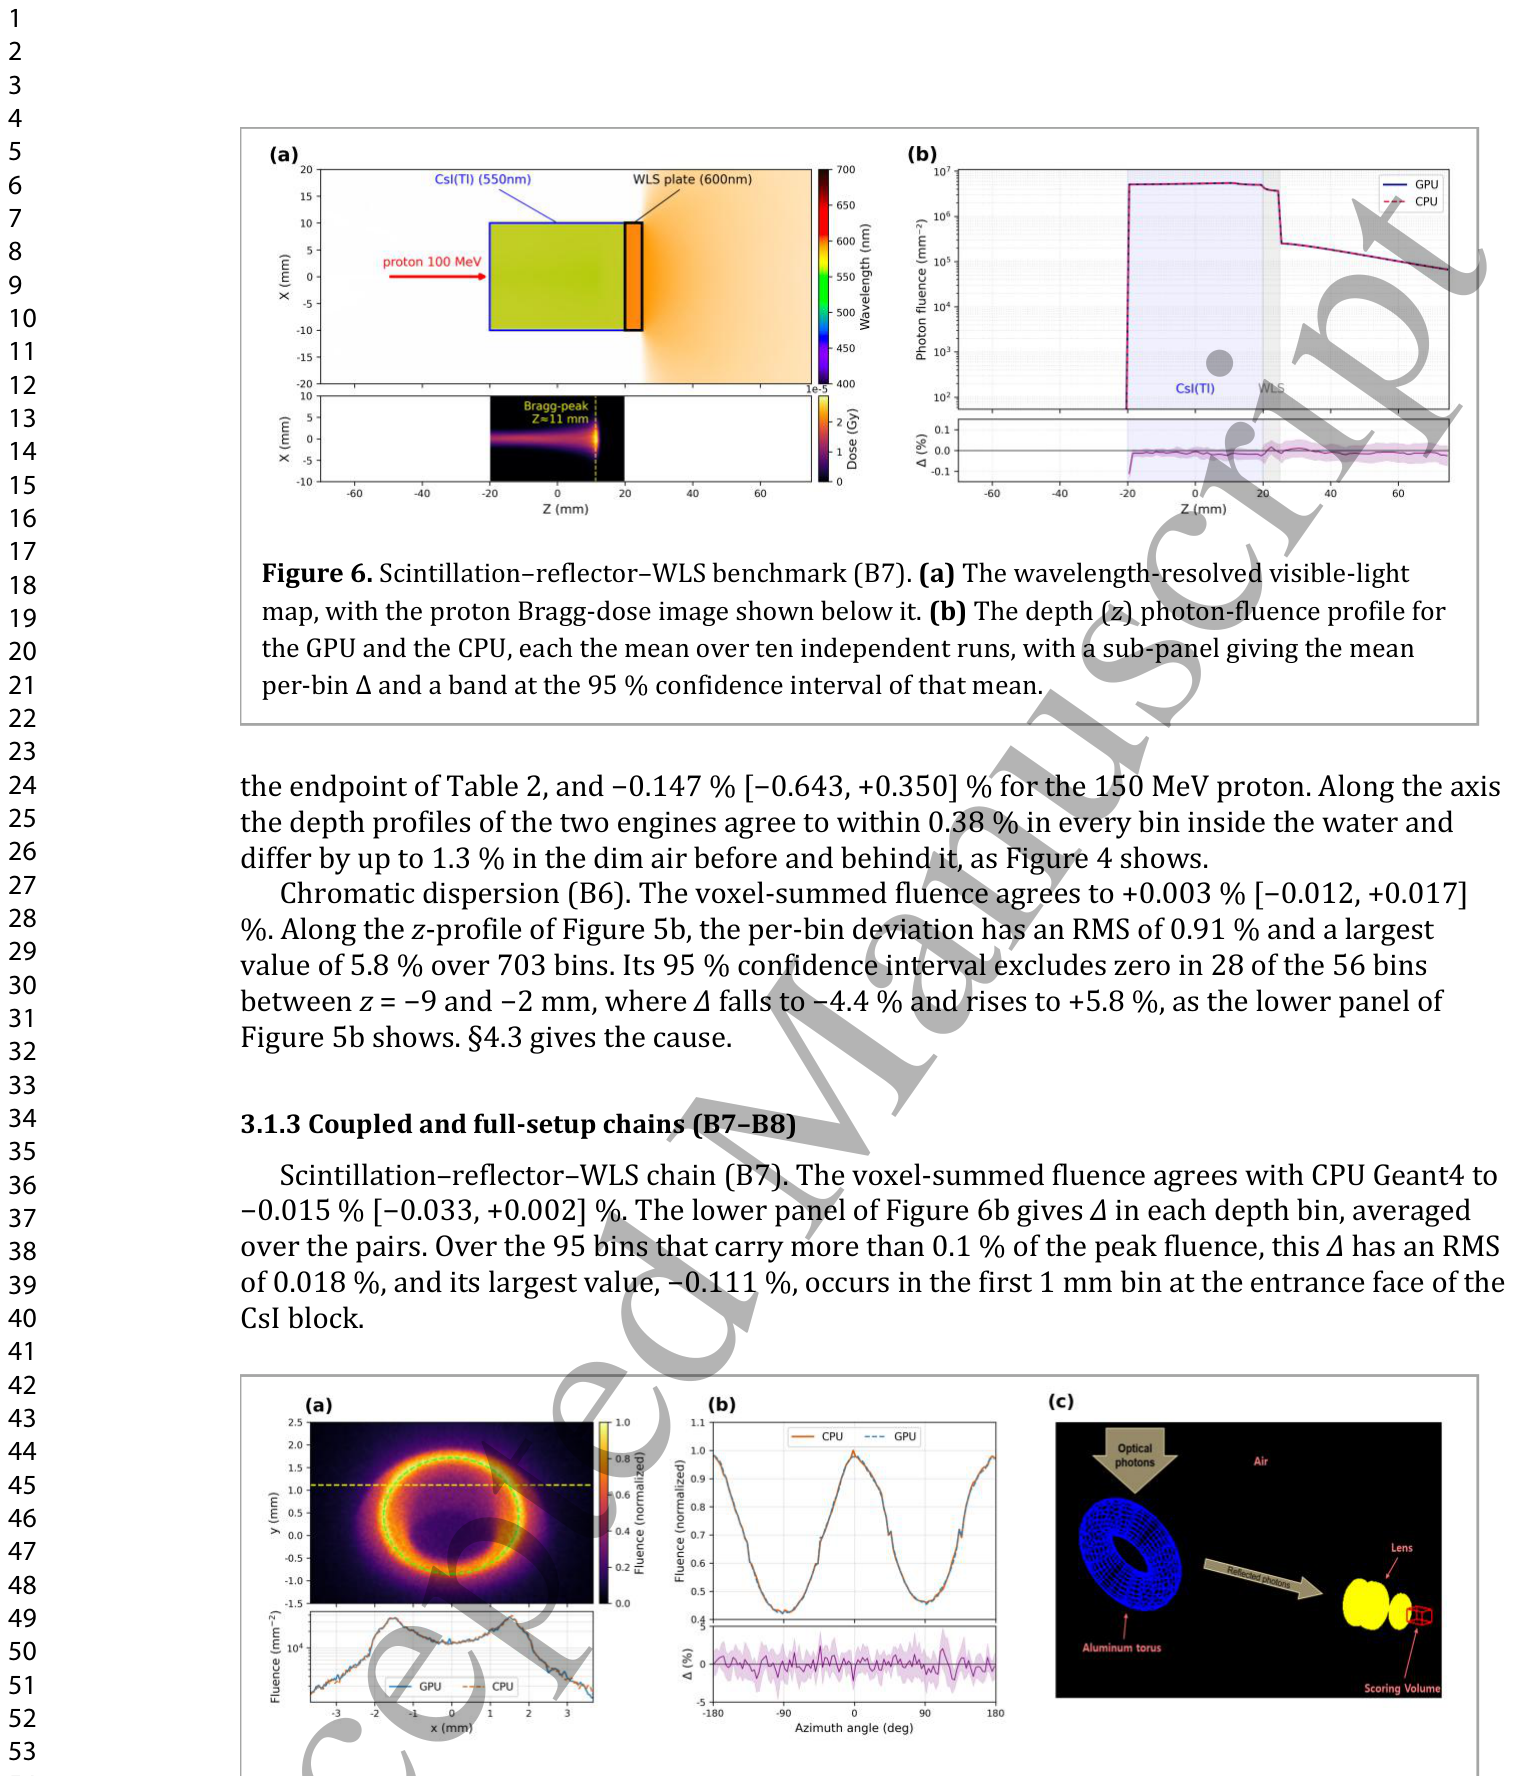
アルミニウム製トーラスミラーとレンズによるイメージングでは、816×624センサー上に明るい楕円状のリングが画像化され、全体画像における体積合計フルエンスは−0.074%で一致しました。
B9(検出器シミュレーション性能)
検出器シミュレーションベンチマーク(B9)では、GPUがシミュレーションを15.7〜32.0倍加速し、105イベントでエンドツーエンドで約24倍高速化しました。(表3)
追加の検出器記録テスト
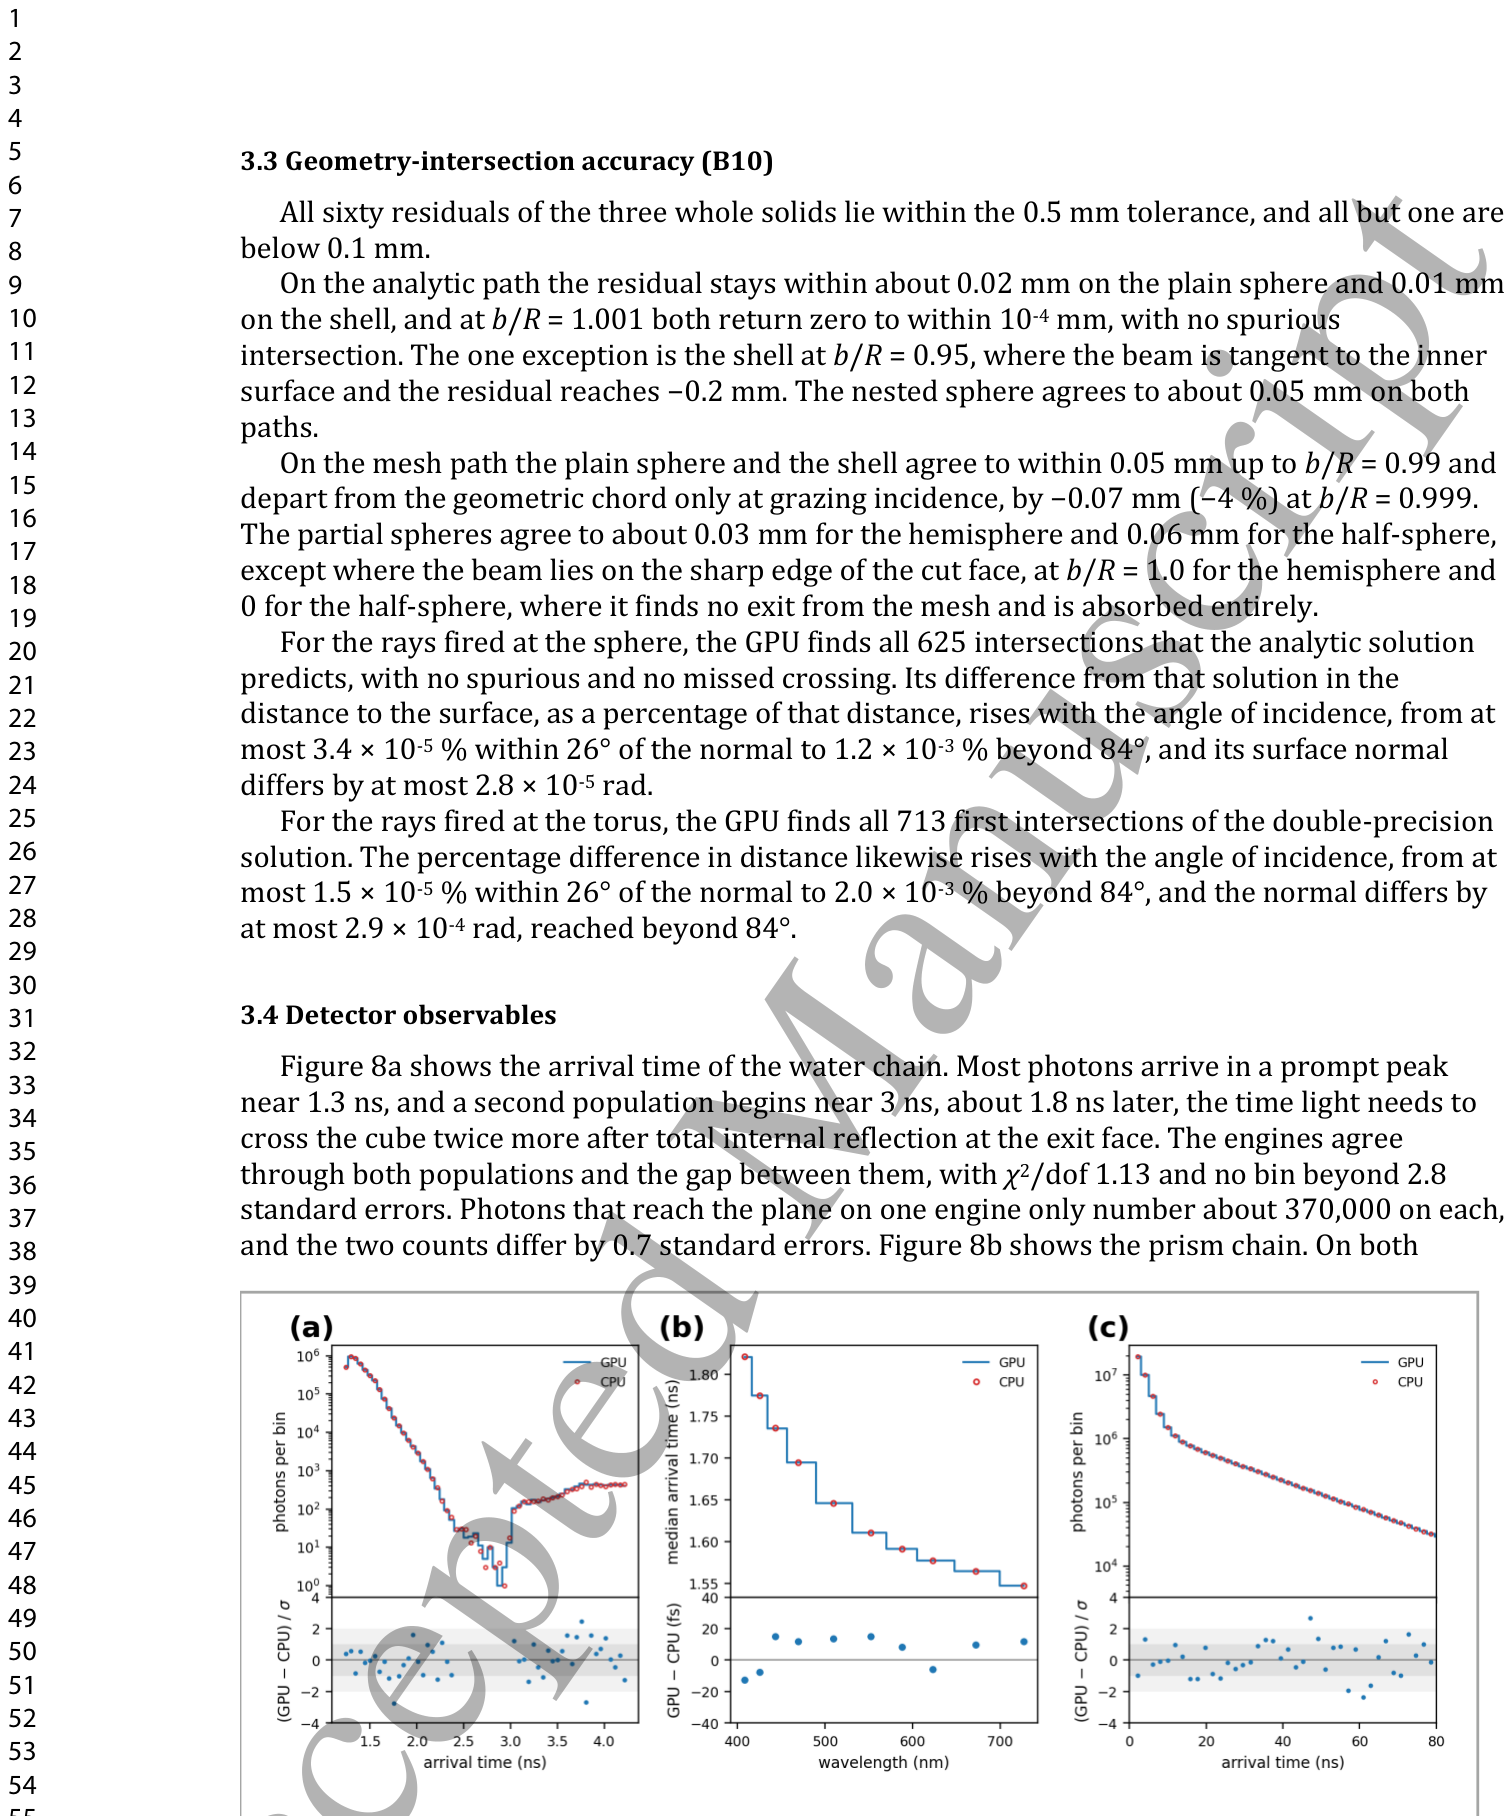
水チェーン、プリズムチェーン、CsI-反射体-WLSチェーンでは、光子の到着時間、波長、入射角、位置、方向余弦が比較され、Geant4と良好な一致を示しました。特に、水チェーンの到着時間プロファイルでは、GPUとCPUで高い一致が見られました。
研究の限界と今後の展望
本研究は、Apple Silicon上のTOPAS拡張機能による光子モンテカルロシミュレーションのGPU加速と検証に成功しました。この成果は、医療物理分野におけるデータセット規模のシミュレーションを現実のものとします。
しかし、現在のところ、この拡張機能はApple Siliconに特化しており、NVIDIAなどの他のGPUプラットフォームでは動作しません。これは、GPUインターフェースとしてMetalを使用しているためです。論文では、他のプラットフォームへの移植の可能性についても言及されていますが、本研究の範囲外です。また、すべてのGeant4光学関数がGPU上で完全に再現されているわけではなく、一部は近似的であるか、またはサポートされていません。
今後の展望としては、この技術を活用して、深層学習による線量または飛程推定のトレーニングセット作成、シンチレータ-カメラ光学系の設計空間最適化、および品質保証のためのパラメータスイープなど、これまで計算コストのために非現実的であった大規模な研究が可能になることが期待されます。これにより、放射線治療計画や診断イメージングの精度と効率がさらに向上するでしょう。
コメントを残す