
共変量データの「ヒープ化」が統計的検出力に与える影響とは?
解説対象論文: Loss of power by degree of heaping in covariables
BMC Medical Research Methodology|被引用数: 0(2026年10月21日時点)
医療研究におけるデータ収集では、回答の丸めや匿名化のためのデータ加工により、数値が特定の区切りに集中する「ヒープ化」という現象がしばしば見られます。このヒープ化が、統計解析における重要な概念である「検出力」にどのような影響を与えるのでしょうか?検出力とは、本当にある効果を研究が正しく見つけ出す能力を指し、その損失は研究結果の信頼性に直結します。本記事では、BMC Medical Research Methodologyに掲載された画期的な論文を基に、このデータ品質の問題が研究の成果にどれほどの影響を及ぼすのかを深掘りします。シミュレーションと実際のデータを用いた分析から見えてくる、ヒープ化の真の代償について詳しく見ていきましょう。
はじめに:医療データにおける「ヒープ化」の課題
どうも、Beyond the Pixelです。医療研究では、年齢や血圧などの連続的なデータを収集することがよくあります。しかし、これらのデータには「ヒープ化(Heaping)」、つまり特定の丸い数値(例:年齢の50歳や60歳、血圧の120mmHgなど)に回答が集中する現象が頻繁に見られます。これは回答者の好みによる場合もあれば、データの匿名化のために意図的に丸められる(データマスキング)場合もあります。これまでの研究では、ヒープ化が回帰係数のバイアス(偏り)に与える影響が検討されてきましたが、データの検出力(Power)にどの程度影響するかについては十分に調査されていませんでした。本記事では、「Loss of power by degree of heaping in covariables」というオープンアクセス論文に基づき、ヒープ化の度合いが検出力に及ぼす影響について、シミュレーション研究と実際のデータ事例を通して解説します。
ヒープ化とは何か?
ヒープ化とは、連続的な数値データにおいて、特定の数値(特に0や5で終わる数字など)に回答が集中する現象、またはデータを特定のカテゴリーに丸めること(ディジット・プリファレンスとも呼ばれる)を指します。例えば、アンケートで正確な年齢を尋ねられたときに「おおよそ50歳」と答える傾向や、データ保護のために年齢を10歳刻みのグループにまとめるなどがこれに当たります。極端なケースとしては、連続変数を二値化(例:30歳以上か未満か)することもヒープ化の一種と見なすことができます。ドイツのNAKOコホート研究では、データ保護の観点から正確な年齢ではなく10年ごとの年齢グループが提供されることがあり、これはポストホック(事後的に)ヒープ化が導入される例です。これまでの研究ではヒープ化の定量化や対処法が主な焦点でしたが、検出力の損失についてはほとんど検討されていませんでした。
シミュレーション研究による検出力の評価
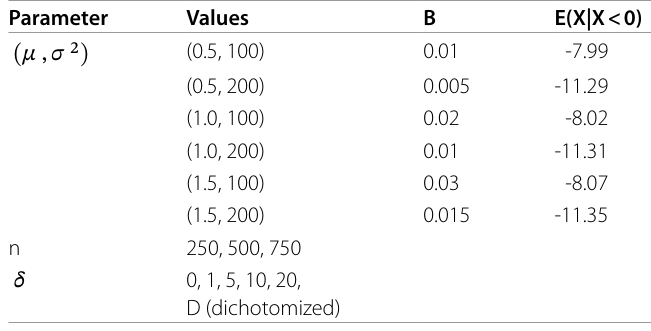
著者らは、ヒープ化の検出力への影響を評価するために、ロジスティック回帰モデルを用いたシミュレーション研究を実施しました。この研究では、二値の結果変数と正規分布に従う連続的な共変量(ヒープ化の対象)を想定しています。様々なパラメーター(効果量、分散、サンプルサイズ)の組み合わせについてデータをシミュレーションし、共変量を特定の丸め値(δ、例:1、5、10、20)で丸める「完全なヒープ化」を適用しました。また、極端なヒープ化として連続変数を中央値で二値化した場合も評価しました。
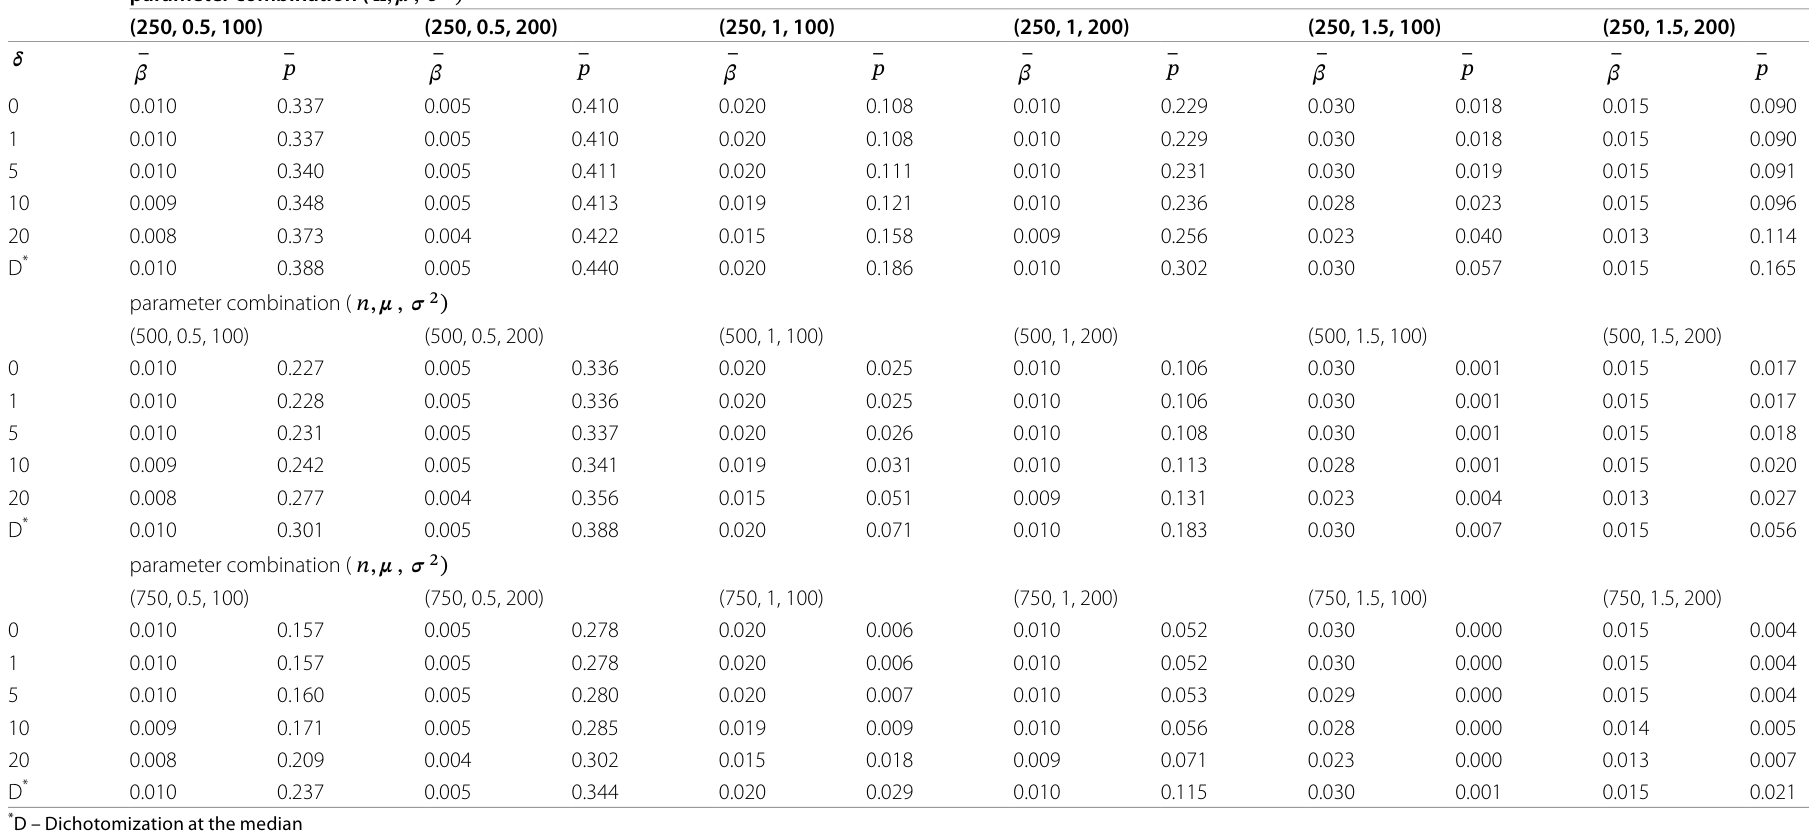
シミュレーションはM=100,000回繰り返され、推定値の平均とp値が記録されました。検出力の損失は、ヒープ化の度合いが増すにつれてp値がどのように変化するかを指標として評価されました。さらに、ヒープ化後の実効サンプルサイズ(Original sample sizeに対する割合)も計算されました。
シミュレーション結果:ゆるやかなヒープ化は許容範囲、粗いヒープ化は大きな損失
シミュレーションの結果は、ヒープ化が粗くなるにつれてp値が歪み、検出力が失われることを明確に示しました。丸め値が5倍程度までの緩やかなヒープ化では、検出力の損失はわずかであり、許容できる範囲であることが示唆されました。しかし、丸め値が20倍など粗いヒープ化になると、検出力の損失は顕著になります。そして、変数を二値化する極端なケースでは、検出力の最も大きな低下が見られました。
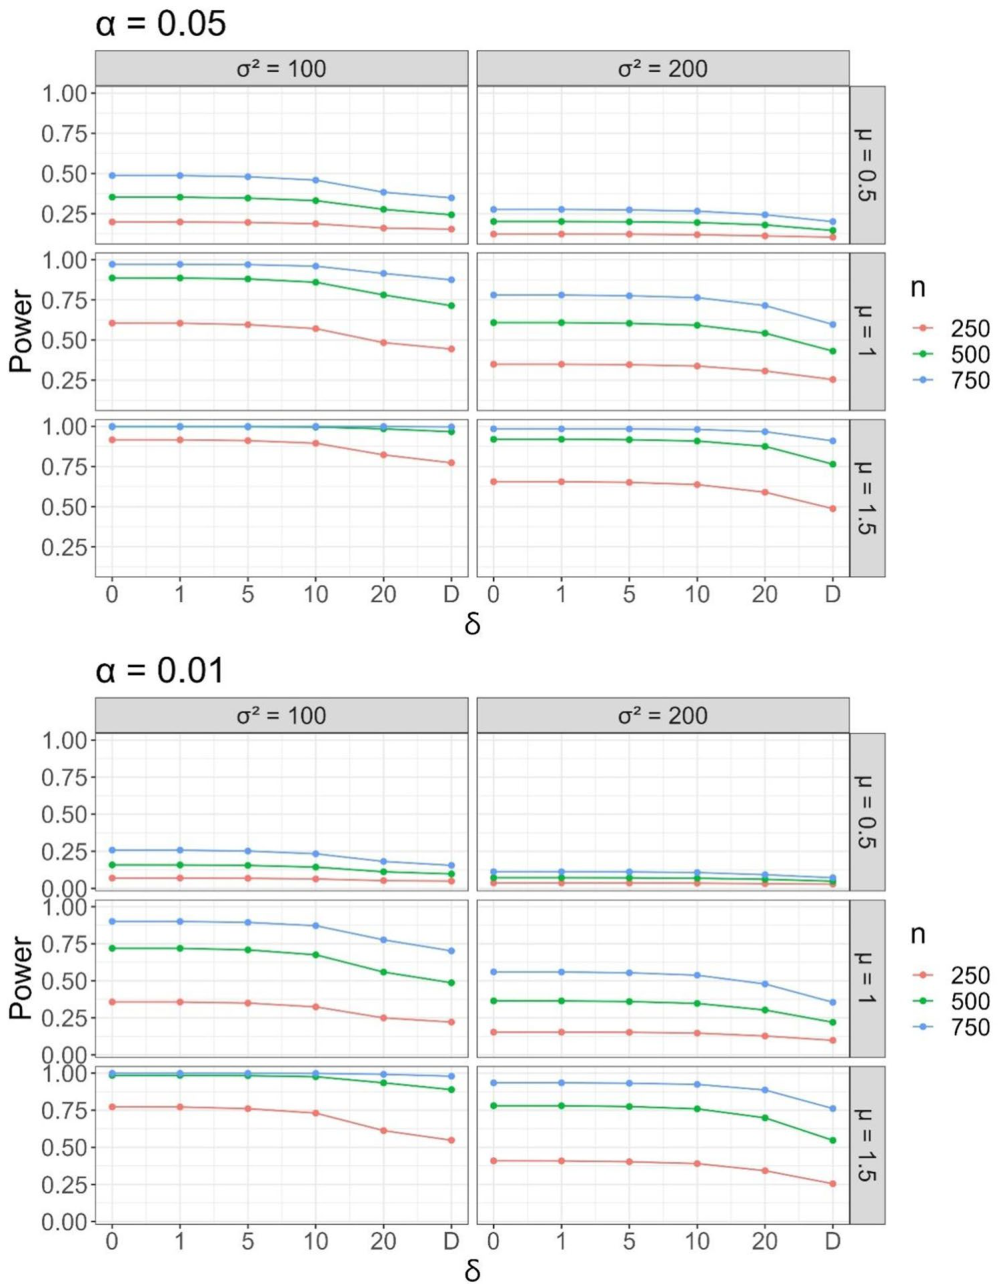
また、ヒープ化の度合いが増すにつれて、実効サンプルサイズも顕著に減少します。二値化の場合には、元のサンプルサイズの約70%まで低下することが示されました。
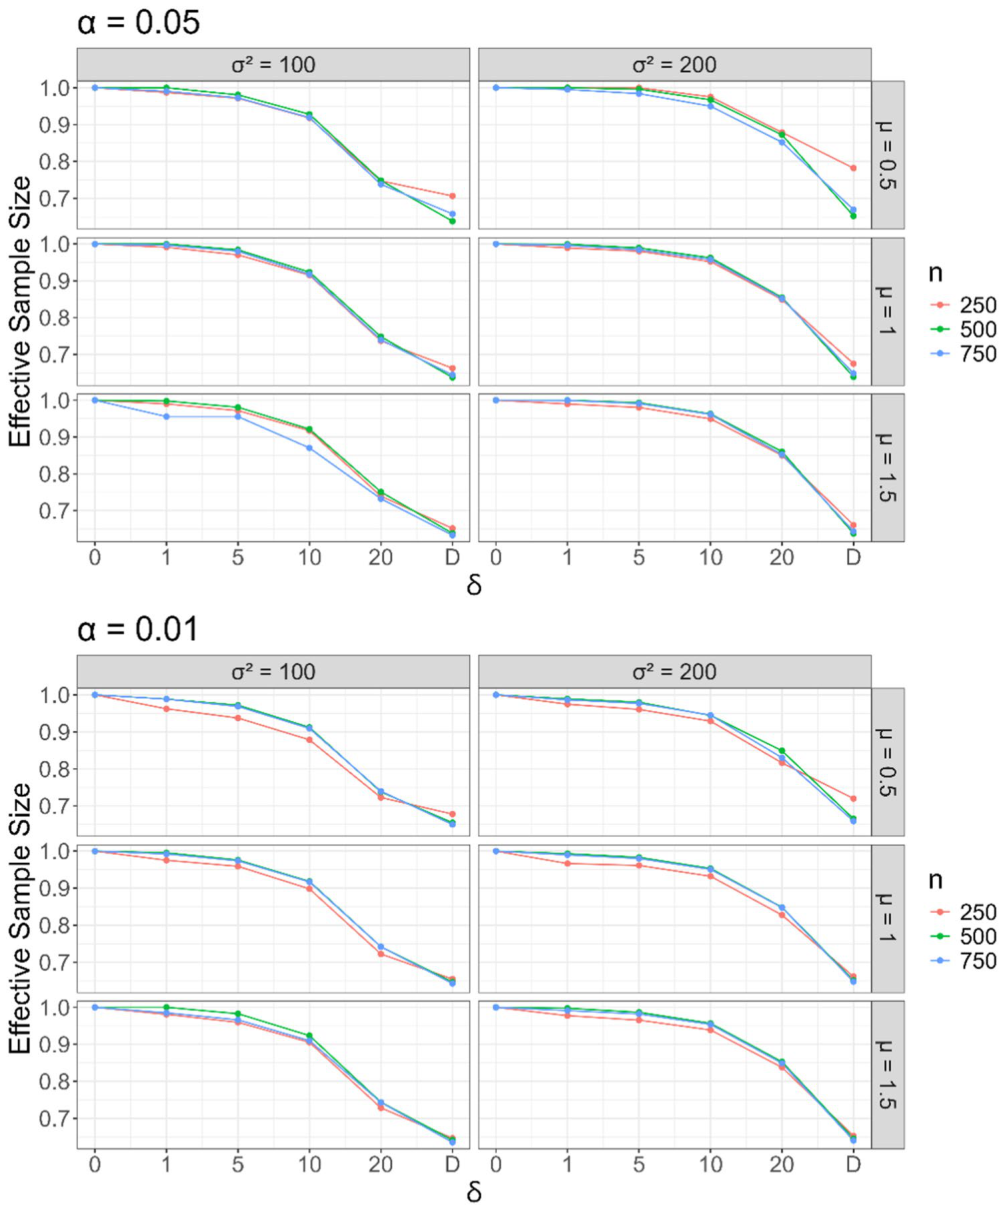
これは、データの情報量が減ることで、同じ効果を検出するために必要なサンプルサイズが増加することを示しています。
実際のデータ例:脳卒中ケースコントロール研究
著者らは、実際のデータを用いてヒープ化の影響を具体的に示しました。ドイツのハイデルベルクで1998年から2000年にかけて実施された脳卒中ケースコントロール研究のデータを使用し、歯周感染が脳卒中リスクに与える影響を主要な目的としていました。この分析では、喫煙年数と総アルコール摂取量を連続変数として使用し、年齢と性別を交絡因子として含めました。元データではヒープ化が少なかったため、この分析のために意図的にヒープ化を導入しました。喫煙年数は2、5、10の倍数に丸め、または中央値(29年)で二値化しました。アルコール摂取量は50、100、200、500の倍数に丸め、または中央値(115.012L)で二値化しました。
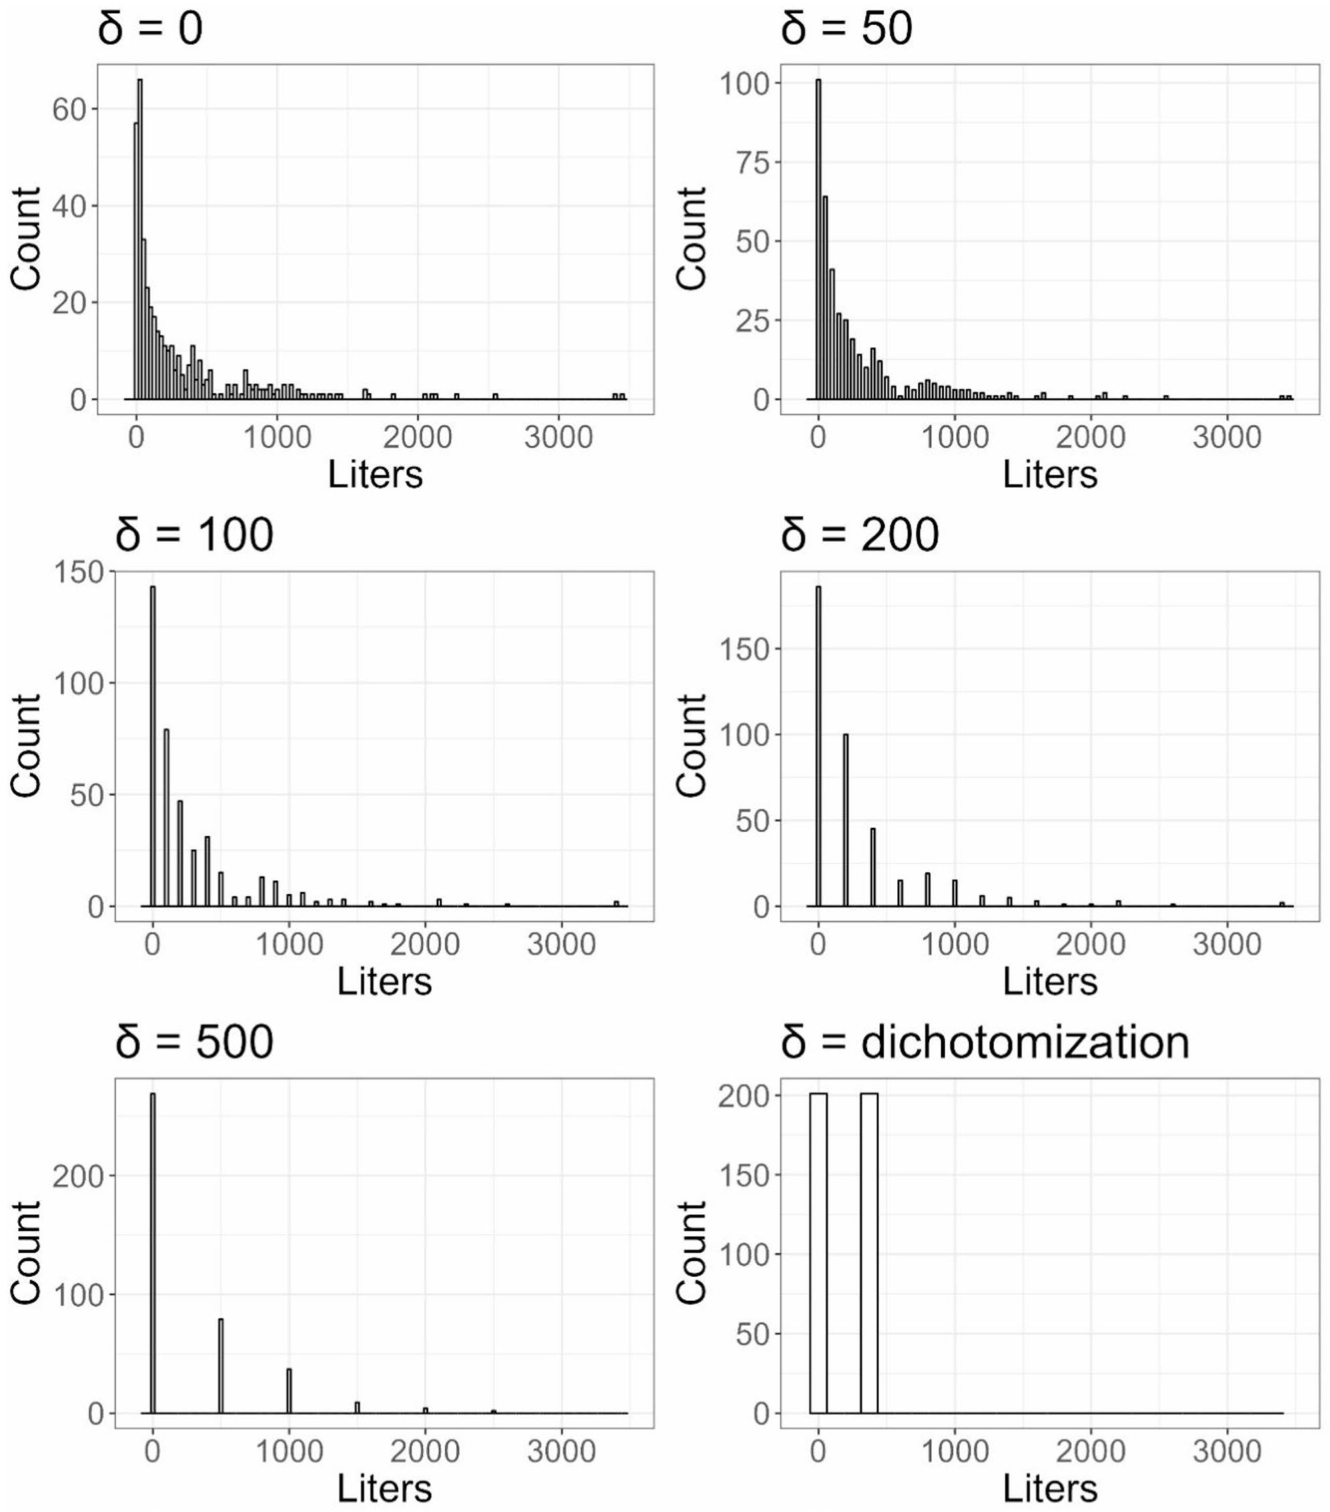
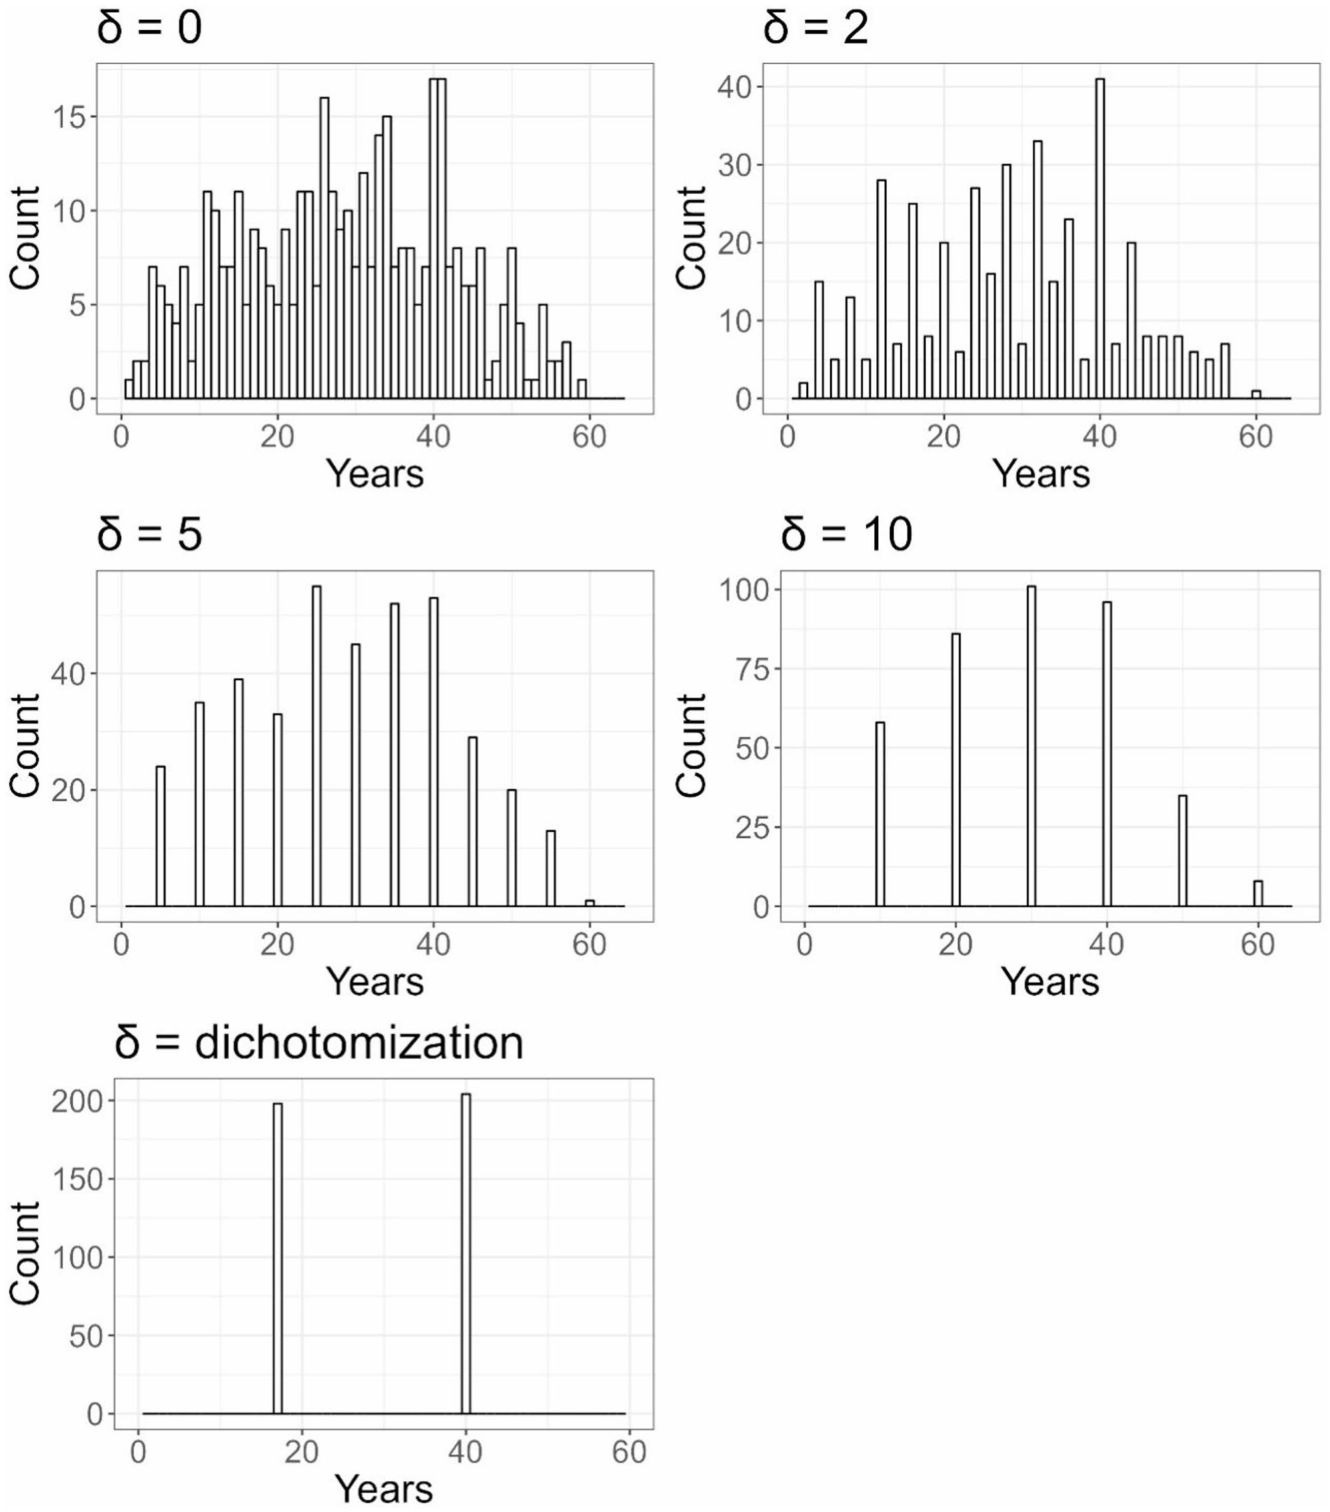
結果として、両変数が二値化された場合、アルコール摂取量のp値は0.049から0.884へ、喫煙年数のp値は0.041から0.124へと大幅に増加しました。これはシミュレーション結果と概ね一致しており、検出力の損失が実際のデータでも起こることを裏付けています。
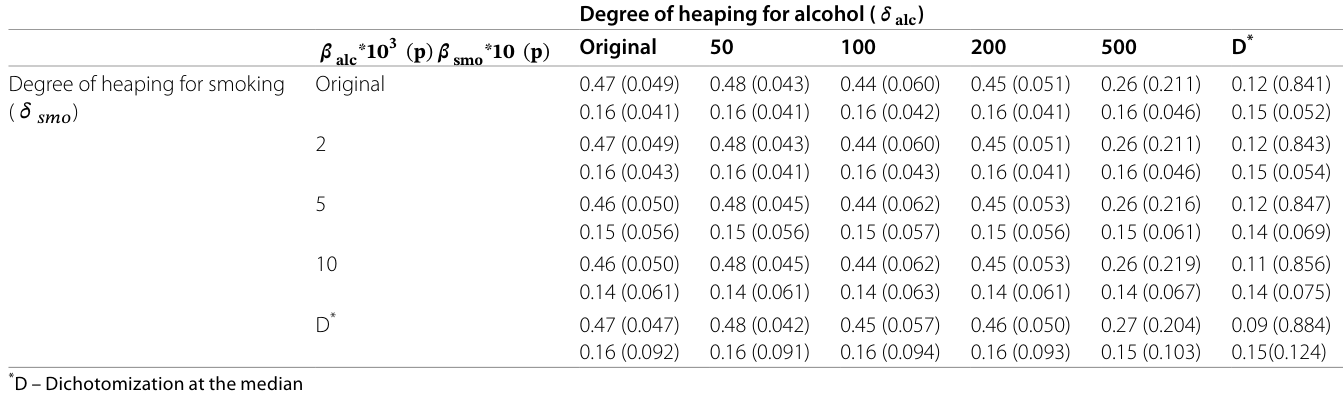
ただし、p値とヒープ化の間に厳密な単調関係は見られない場合もあり、データ構造によっては予測が難しい影響が出ることが示唆されました。
考察:データ保護と統計的情報損失のバランス
ヒープ化は、観測データでよく見られるものであり、一種の測定誤差と考えることができます。軽度なヒープ化は統計的観点から許容できる程度の検出力損失しかもたらしませんが、二値化のような極端なヒープ化は、効果推定値の歪みや変数選択の誤り、ひいては結論の重大な誤りにつながる可能性があります。この論文の知見は、統計的開示制御(SDC)やデータ共有における匿名化手法にも関連します。個人を再特定できないようにデータを匿名化する際に、「バケッティング関数」(bucketing function)と呼ばれるヒープ化の一種が用いられることがあります。この研究では、データ保護と引き換えに情報損失を最小限に抑える適切なヒープ化のレベルを検討することの重要性が強調されています。例えば、NAKOコホート研究における10年ごとの年齢グループ化は、検出力損失が小さいことから許容できると結論付けられています。結論として、軽度なヒープ化は実務上一般的であり、統計的に許容可能ですが、連続変数の二値化やごく少数のカテゴリーに丸めるような極端なヒープ化は避けるべきです。
用語集
- ヒープ化 (Heaping): 連続的な数値データにおいて、特定の丸い数値に回答が集中する現象、またはデータを特定のカテゴリに丸めること。ディジット・プリファレンスとも呼ばれる。
- 検出力 (Power): 統計的仮説検定において、帰無仮説が偽である場合に、それを正しく棄却する確率。研究で本当に効果がある場合、その効果を統計的に見つけ出す能力を指す。
- 共変量 (Covariables): 結果変数に影響を与える可能性のある要因で、研究の主要な対象ではないが、その影響を考慮する必要がある変数。
- ロジスティック回帰モデル (Logistic Regression Model): 結果変数が二値(例:病気であるかないか)の場合に、予測変数と結果変数の関係を分析するための統計モデル。
- 二値化 (Dichotomization): 連続的な変数を、特定のカットオフ値に基づいて二つのカテゴリ(例:高い/低い、あり/なし)に変換すること。ヒープ化の極端なケース。
- p値 (p-value): 統計的仮説検定において、観測されたデータ、あるいはそれよりも極端なデータが得られる確率。通常、p値が小さいほど統計的に有意と判断される。
- 実効サンプルサイズ (Effective Sample Size): データに情報損失がある場合に、元のデータと同等の統計的検出力を得るために必要な、調整されたサンプルサイズ。情報損失が大きいほど実効サンプルサイズは小さくなる。
- 統計的開示制御 (Statistical Disclosure Control, SDC): 統計データを公開する際に、個人の特定可能性を防ぎつつ、データの有用性を維持するための手法。
コメントを残す