
複雑数値脳MRIデータ生成:位相情報で診断の未来を拓く
解説対象論文: Generative modeling of complex-valued brain MRI data
Physics in Medicine and Biology|被引用数: 0(2026年10月8日時点)
磁気共鳴画像診断(MRI)は脳腫瘍診断において不可欠ですが、現在の標準的な画像再構成プロセスでは、組織の特性を詳細に反映する「位相情報」が捨てられています。この重要な情報を活用するため、本研究はマグニチュードと位相の両方を統合してモデル化する新しい生成AIフレームワークを開発しました。これにより、正常および異常な脳組織を表すMRI画像を条件付きで生成することが可能になり、将来的な診断精度の向上や、侵襲的な生検の必要性を減らす可能性を秘めています。
はじめに
どうも、Beyond the Pixelです。2022年には世界中で32万件以上の脳および中枢神経系がんの新規症例が報告されており、その正確な分類は臨床上の意思決定と治療に極めて重要です。磁気共鳴画像診断(MRI)は、対象者を電離放射線にさらすことなく良好な軟組織コントラストを提供できるため、腫瘍診断において最も推奨される画像診断法です。しかし、MRIは腫瘍の存在と位置を特定するのに効果的である一方で、画像のみから正確な種類を特定することは困難です。過去の研究では、初期のMRI診断と最終的な病理組織学的結果との間に高い不一致率が示されています。例えば、脳腫瘍のMRI診断の約30%が治療計画に影響を与える形で異なると報告されており、小児腫瘍でも27.45%と同様の誤分類率が報告されています。このような診断の不一致を考えると、生検のような病理組織学的分析は診断プロセスにおいて依然として不可欠です。しかし、脳生検はその侵襲性により固有のリスクを伴い、システマティックレビューでは処置関連の死亡率が0.7〜4%、全体的な臨床的罹患率が3〜13%と報告されています。MRIから腫瘍の種類を正確に判断することで、侵襲的な生検の必要性を減らすことができれば、対象者の安全と治療成果を直接的に向上させることが期待されます。これまで多くの研究がMRIベースの腫瘍分類を改善するための機械学習(ML)モデルを提案してきましたが、これまでのアプローチでは、臨床現場で侵襲的な生検を置き換えるには至っていません。これらの研究は、MRIスキャナによって生成される最終的な画像に依存しているという共通の限界を抱えています。これらの画像は複雑な再構成パイプラインの結果であり、元々収集された情報の全てを保持しているわけではありません。MRIスキャナは、取得中に画像化されたオブジェクトの生の信号を空間周波数領域(k空間)で収集します。このk空間データは逆フーリエ変換(IFT)を用いて画像領域に変換され、そのマグニチュード(強度)と位相が局所的な組織特性を反映する複雑数値画像となります。標準的な結合アルゴリズムは、マグニチュード情報のみに依存することがほとんどです。これは、これらの画像が人間にとって直接解釈可能であるためです。しかし、この際に通常捨てられる位相情報(phase information)は、デオキシヘモグロビンや鉄のような常磁性物質、カルシウムのような反磁性物質に起因する局所的な磁化率変動に敏感です。脳腫瘍は腫瘍内微小出血や鉄沈着によってこれらの磁気特性を変化させるため、捨てられていた位相情報には診断上価値のある情報が含まれている可能性があります。したがって、位相情報を考慮することで、マグニチュードMRI画像ではほとんど見えない、あるいは全く見えない解剖学的構造や腫瘍の特徴が明らかになる可能性があります。
脳MRIデータ生成の新しい枠組み
MRIベースの腫瘍診断における位相情報の調査を可能にするため、生成ニューラルネットワークの使用が有望なアプローチです。リアルな複雑数値MRIサンプルを生成することを学習することで、そのようなモデルは合成トレーニングデータのソースとして機能します。この機能は、生のMRIデータセットが希少であり、特に病理学的ラベル付きデータが非常に少ない場合に特に重要です。さらに、生成モデルはトレーニングデータの内部特徴表現(潜在空間)を学習し、マグニチュードと位相がどのように病理特異的な特徴を共同でエンコードするかを体系的に分析することを可能にします。先行研究では、構造化された潜在空間を使用してマグニチュード画像から疾患組織のMRIスキャンを合成・分析することでこの可能性が示されています。しかし、現在、この提案された生成アプローチが位相がマグニチュードを超えた診断情報を提供するかどうかを調査するために使用されるのを妨げる2つの本質的な限界があります。第一に、マグニチュードと位相情報を共同でモデル化する生成フレームワークが存在しません。最も近い既存の研究は、既存のマグニチュードデータに基づいて位相画像を合成する拡散モデルですが、2つのコンポーネントを別々に扱い、共同でモデル化していません。第二に、生検で確認されたラベルとペアになった十分に大規模な生のMRIデータセットが利用できません。本研究は、正常および異常な複雑数値脳MRIデータのマグニチュードと位相情報を共同でモデル化する生成フレームワークの開発に焦点を当てることで、第一の限界に対処しています。この目的は、マグニチュードと位相の共同モデリングの実現可能性を示すことが目標であるため、画像由来の異常アノテーションで達成できます。このフレームワークを確立するために、以下の2つの主要な課題が対処されました。1. マグニチュードと位相情報の結合を維持し、その後の生成モデルが機能するための構造化された表現を提供する、複雑数値MRIスキャンのコンパクトな潜在表現を学習すること。2. ラベルが不足している状況下で、正常および異常な脳組織を条件付きで生成すること。これは、まず利用可能な全てのデータからシーケンス特異的な脳の解剖学的構造を学習し、その後、異常状態を条件とする合成のために、より小さなラベル付きサブセットで微調整するという2段階のトレーニング戦略を通じて対処されました。生成されたデータの品質を評価するため、下流の分類モデルが生成データでトレーニングされ、異常組織検出におけるその性能が合成品質の定量的尺度として機能します。この評価は、トレーニング分布から保持されたテスト分割だけでなく、生検確認済みラベルを持つ独立した外部テストセットでも行われます。
生成モデルの全体的なワークフロー
複雑数値MRIパッチを生成するためのワークフローは、3つの段階的なステージで構成されます。
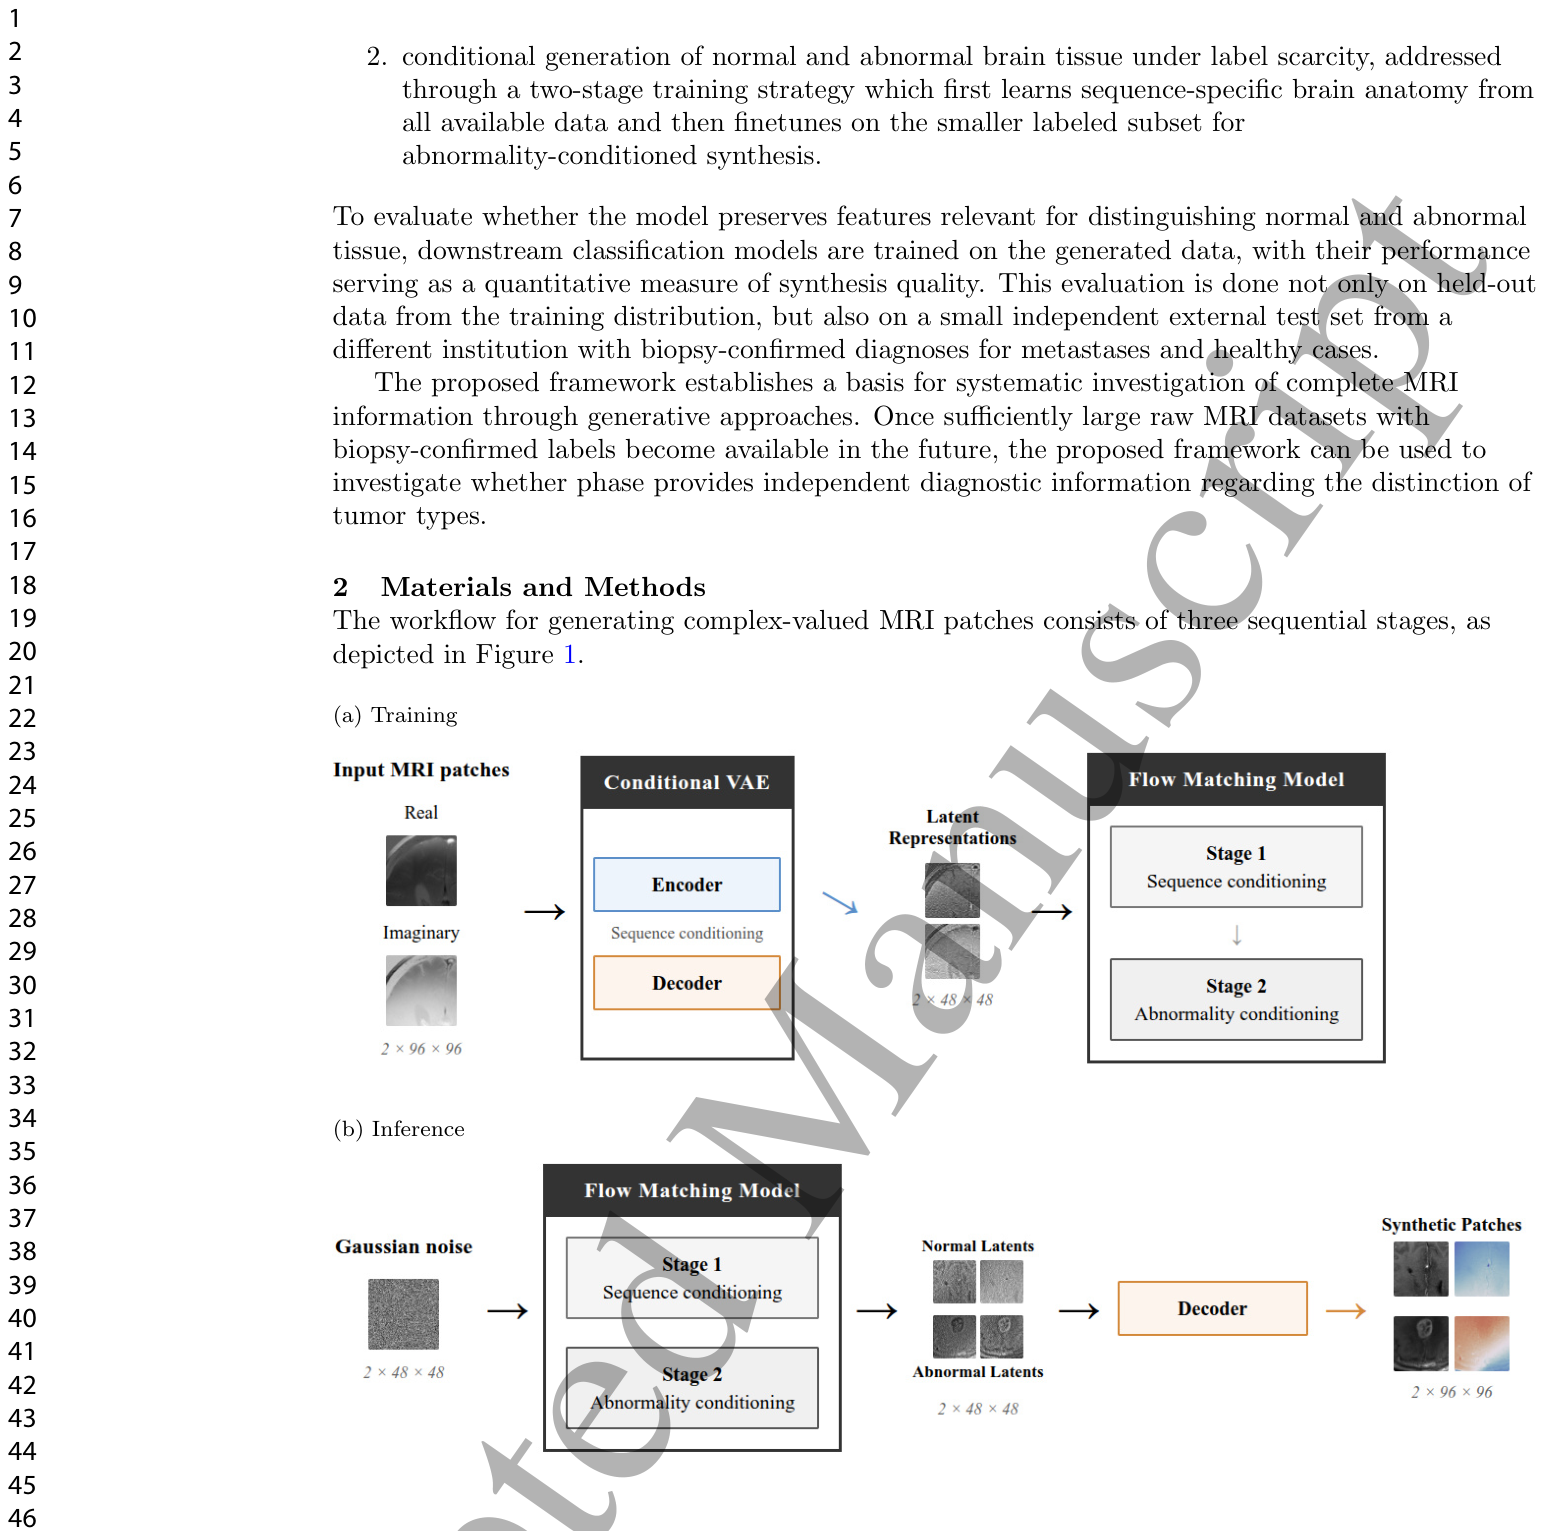
まず、オートエンコーダが複雑数値MRIパッチをコンパクトな潜在表現に圧縮するようにトレーニングされます。これらのパッチは、完全なMRIボリュームから抽出された小さな画像の一部であり、各パッチは複雑数値データの「実部」と「虚部」をエンコードする2チャンネル入力として表現されます。潜在表現は、その後、条件付きフローマッチングモデルのトレーニングデータとして機能します。このフローマッチングモデルのトレーニングは2段階で進行します。第1段階では、モデルはシーケンス特異的な脳パッチの潜在表現を生成することを学習します。第2段階では、事前学習されたモデルが、異常ラベルを条件として追加で学習するように適応され、正常および異常組織のターゲット生成を可能にします。生成されたデータの品質を評価するため、各ステージで分類器がトレーニングされます。
複雑なMRIデータを圧縮する「オートエンコーダ」
抽出されたfastMRIデータセットからのパッチは、生成パイプラインの最初のステージであるオートエンコーダの入力となります。このオートエンコーダは、複雑数値データをコンパクトな潜在表現に圧縮します。この圧縮には2つの目的があります。1つは、後続のフローマッチングモデルが処理しなければならない次元数を削減すること、もう1つは、実数チャンネルと虚数チャンネル間の結合を捉えることです。これらのチャンネルは独立した信号ではなく、局所的な位相をエンコードする単一の複雑数値測定を共同で表しているため、両者間の関係が明示的に保持されなければなりません。アーキテクチャは、ResNetベースの条件付き変分オートエンコーダ(CVAE)として実装されています。エンコーダは各(2 × 96 × 96)の入力パッチを(2 × 48 × 48)サイズの潜在表現にマッピングし、圧縮率は4となります。この圧縮率は、フローマッチングモデルに十分コンパクトな入力サイズを提供しつつ、診断上の細かい詳細とチャンネル間の結合を保持するように選択されました。デコーダは、この圧縮されたエンコードから元のパッチを再構築します。オートエンコーダは、5つのMRI取得シーケンスがそれぞれ異なるグローバルな強度と位相分布を生成するため、これらの違いを再構成中に考慮するために取得シーケンスに条件付けされています。これは、学習されたスケールおよびシフトパラメータを中間活性化に適用するFeature-wise Linear Modulation (FiLM) 条件付けによって達成され、エンコーダとデコーダが各シーケンスの特性に適応できるようにします。一方、この段階ではクラスラベルへの条件付けは必要ありません。オートエンコーダの目的は純粋に再構成的であるため、異常は局所的な解剖学的パターンとして扱われ、明示的なクラス情報なしに正確に再構成できます。これにより、クラスラベルを持たないAXT2やAXT1PREを含むすべてのシーケンスで単一のオートエンコーダをトレーニングすることも可能になります。再構成品質は、構造類似度指数(SSIM)とピーク信号対雑音比(PSNR)を使用して評価されました。位相情報が保持されているか評価するため、予測値とターゲット値間の位相コヒーレンスが測定されました。本研究では、位相コヒーレンスがすべてのシーケンスで0.997以上を維持しており、オートエンコーダが位相情報を正常に保持していることが示されました。マグニチュードの再構成品質も高く、SSIMは0.93を超え、PSNR値は35.0から36.5 dBの範囲であり、構造の詳細とピクセルレベルの強度の両方がよく保持されていることが確認されました。
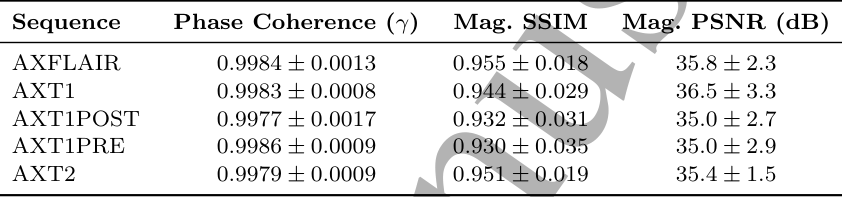
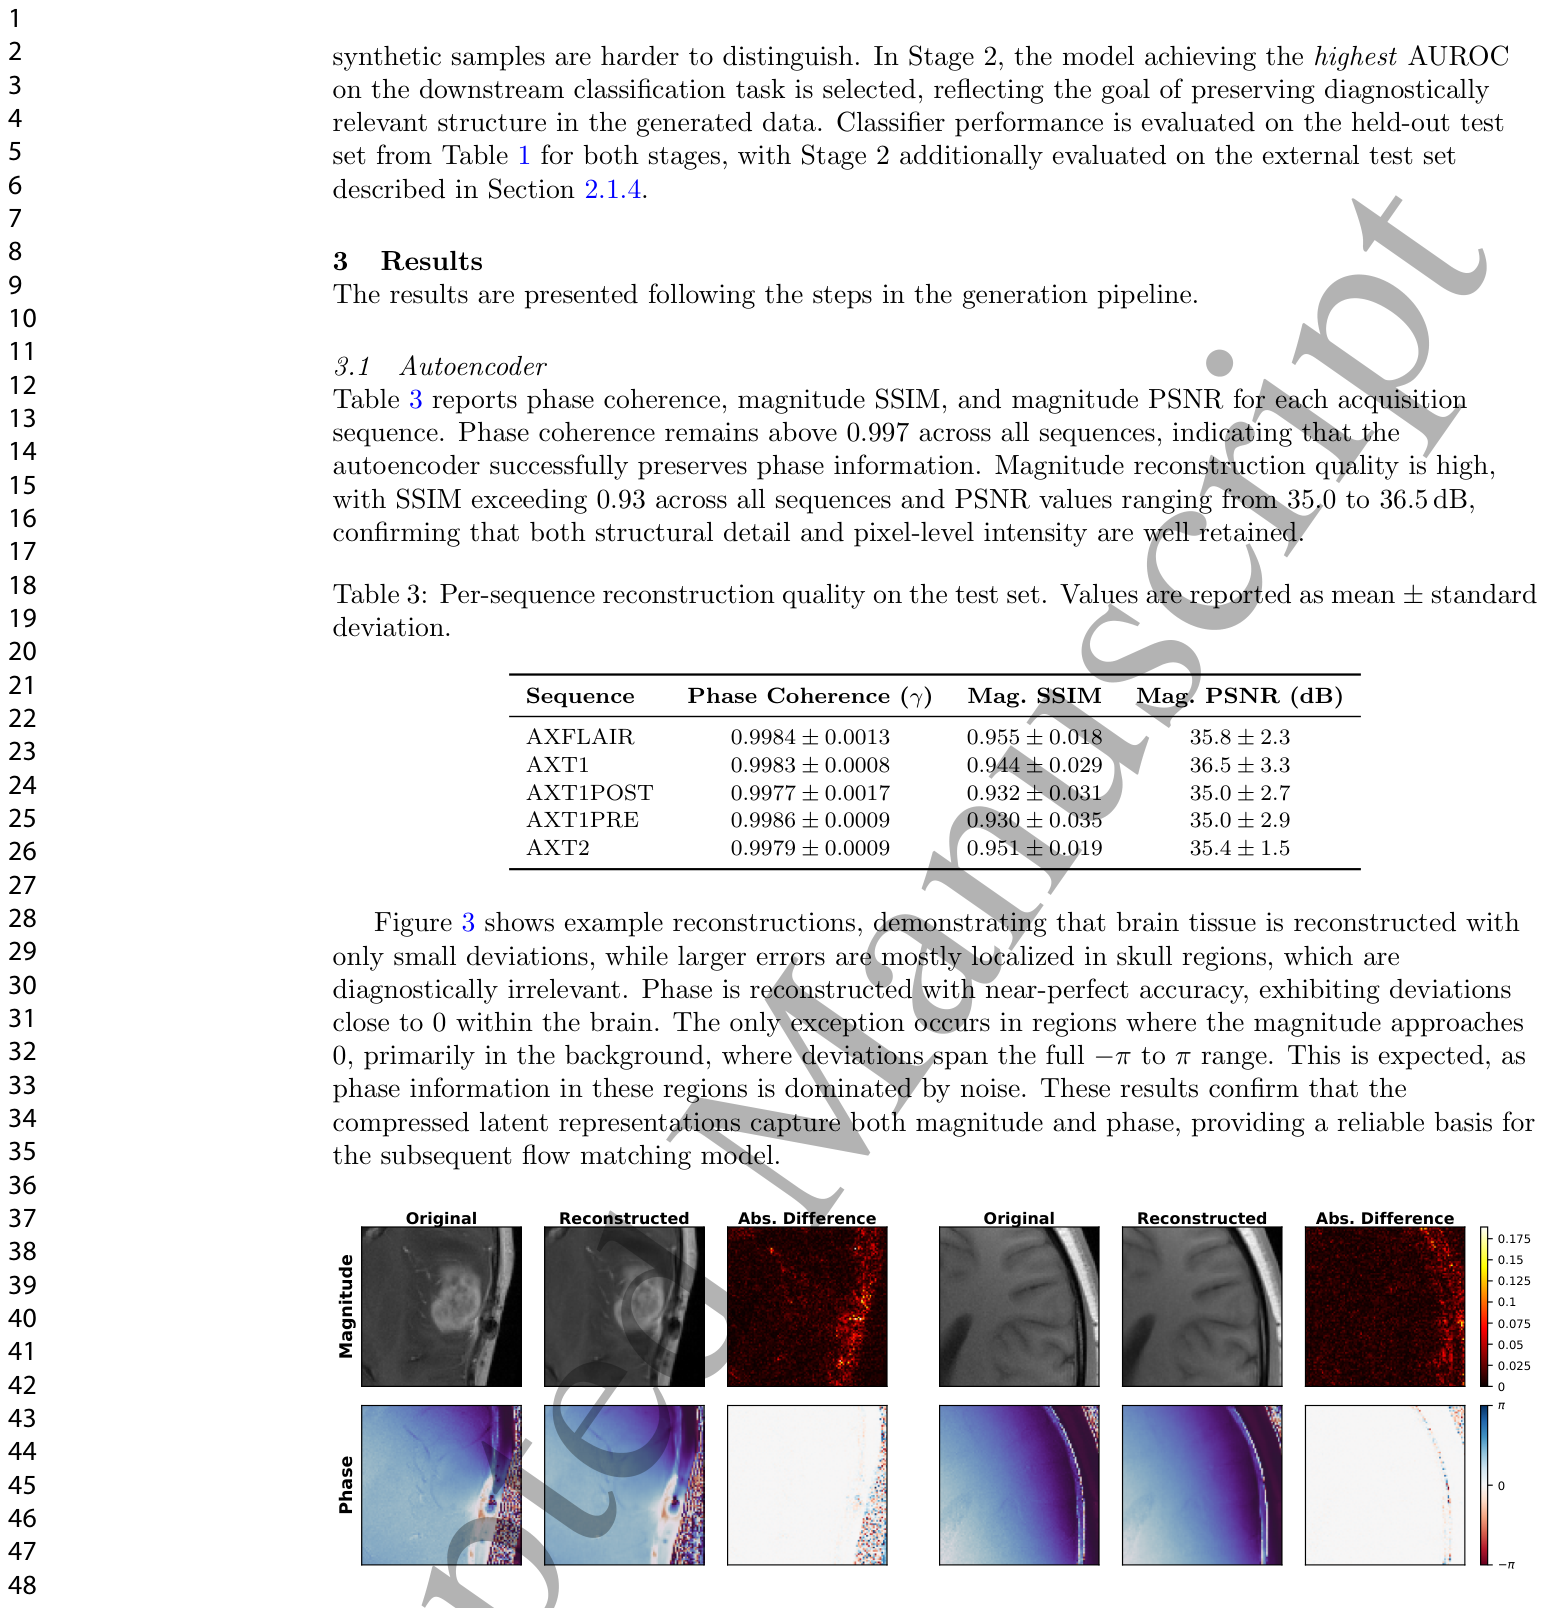
この図は、オートエンコーダの再構成例を示しており、脳組織はわずかな偏差で再構成され、より大きな誤差は主に診断上無関係な頭蓋骨領域に局在していることが分かります。位相はほぼ完璧な精度で再構成されており、脳内では0に近い偏差を示しています。唯一の例外は、マグニチュードが0に近づく領域、主に背景で発生し、偏差が−πからπの全範囲にわたっていますが、これはこれらの領域の位相情報がノイズに支配されるため、予測される結果です。これらの結果は、圧縮された潜在表現がマグニチュードと位相の両方を捉えていることを確認し、後続のフローマッチングモデルの信頼できる基盤を提供します。
マグニチュードと位相を統合する「フローマッチングモデル」
オートエンコーダによって生成された潜在表現は、マグニチュードと位相情報の両方をコンパクトな形式で保持します。これらの表現に基づき、フローマッチングモデルは、それらの分布を学習し、そこから新しいサンプルを合成するためにトレーニングされます。フローマッチングは、クリーンなサンプルにガウスノイズを徐々に加えていくことで機能します。トレーニングは2段階で進行し、各段階でモデルの機能と受け取る条件情報が拡張されます。第1段階では、モデルは取得シーケンス(c = cseq)のみに条件付けされ、さらなる条件なしに現実的な複雑数値MRI潜在表現を生成するモデルの能力を確立します。第2段階では、事前学習されたモデルは、クラスラベル(c = [cseq, cpath])に追加で条件付けするように微調整され、正常組織と異常組織を区別します。これにより、各カテゴリのターゲット生成が可能になり、モデルが潜在空間で病理と関連付けて学習する特徴を調査するための基盤が提供されます。第1段階のフローマッチングモデルによって生成されたサンプルは、比較のために示されている実際のサンプルと並べて、異なるシーケンスに条件付けされた出力として見ることができます。
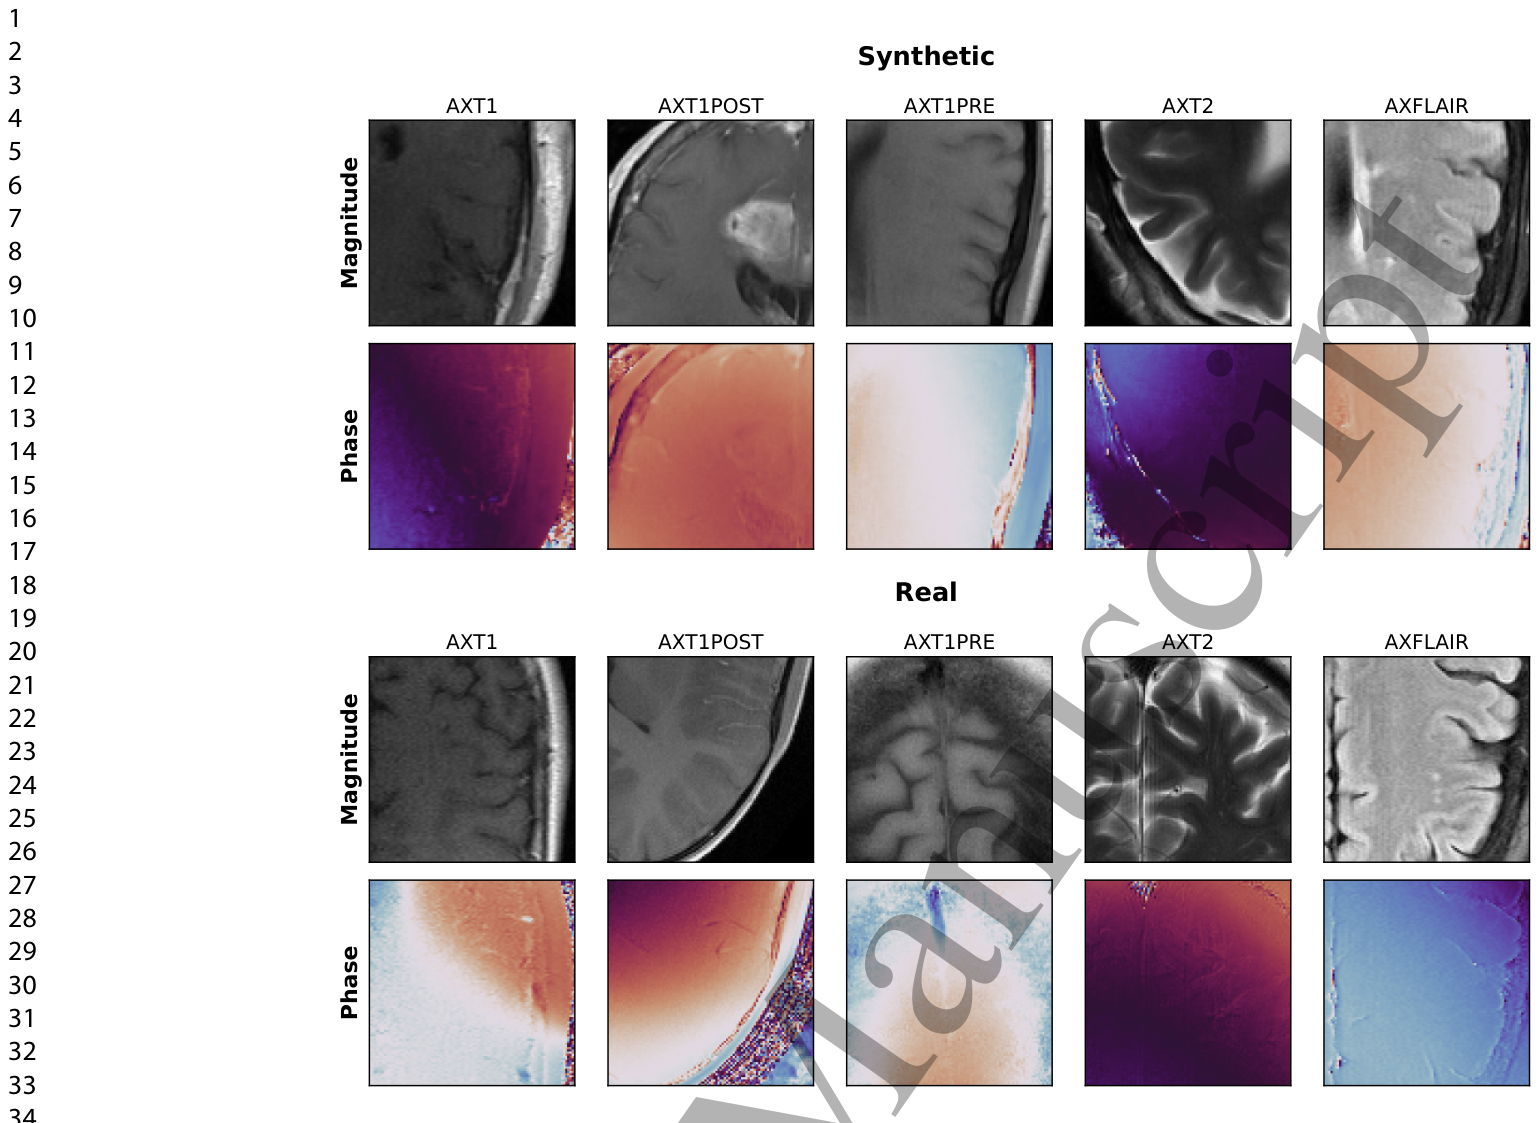
生成されたサンプルは、実際のデータのシーケンス固有のコントラスト特性と一致し、解剖学的に妥当に見え、一貫したマグニチュードと位相の構造を示しています。第2段階のフローマッチングモデルによって生成された、正常クラスと異常クラスに条件付けされた出力の例を以下に示します。
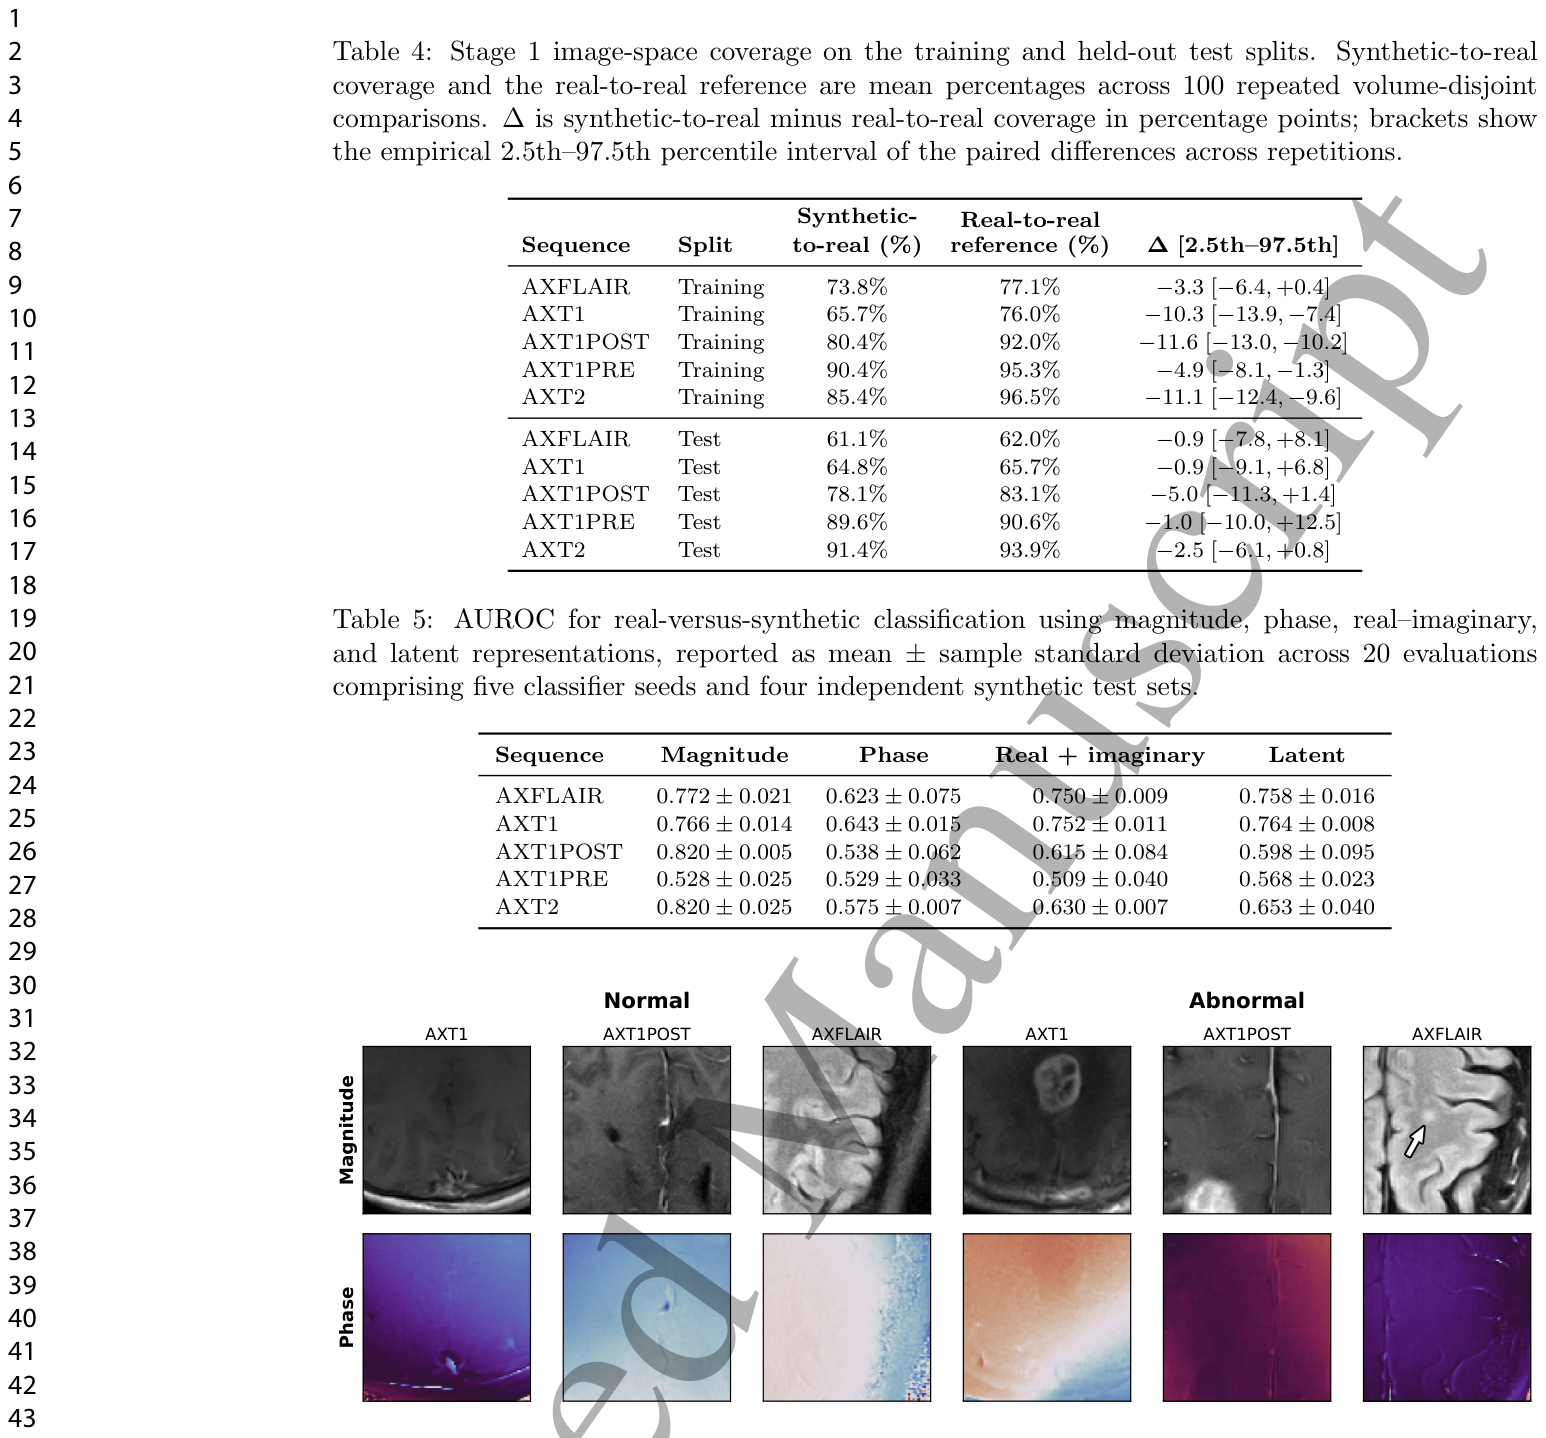
異常サンプルでは、腫瘍様および病変様構造が明確に確認でき、形態、位置、サイズが多様です。例えば、異常なAXT1サンプルは顕著な腫瘍様塊を示している一方で、AXFLAIRサンプルは微妙な白質病変様の異常(白い矢印で強調表示)を示しています。モデルはまた、様々な空間位置で異常を生成します。AXT1POST異常サンプルでは、病理学的領域が下端に位置し、パッチ内で部分的にしか見えません。対応する位相画像はマグニチュード画像と一貫しており、同様に異常を反映しています。AXT1およびAXT1POSTの異常位相画像の両方で、腫瘍領域はより暗い領域として現れます。マグニチュードおよび位相チャンネルにおける異常出現のこの多様性は、モデルが異常組織と関連する豊かな特徴セットを学習したことを示唆しています。データは、fastMRI脳データセット(1.5Tおよび3Tで取得された6,970の脳MRIスキャン)を使用してトレーニングされました。
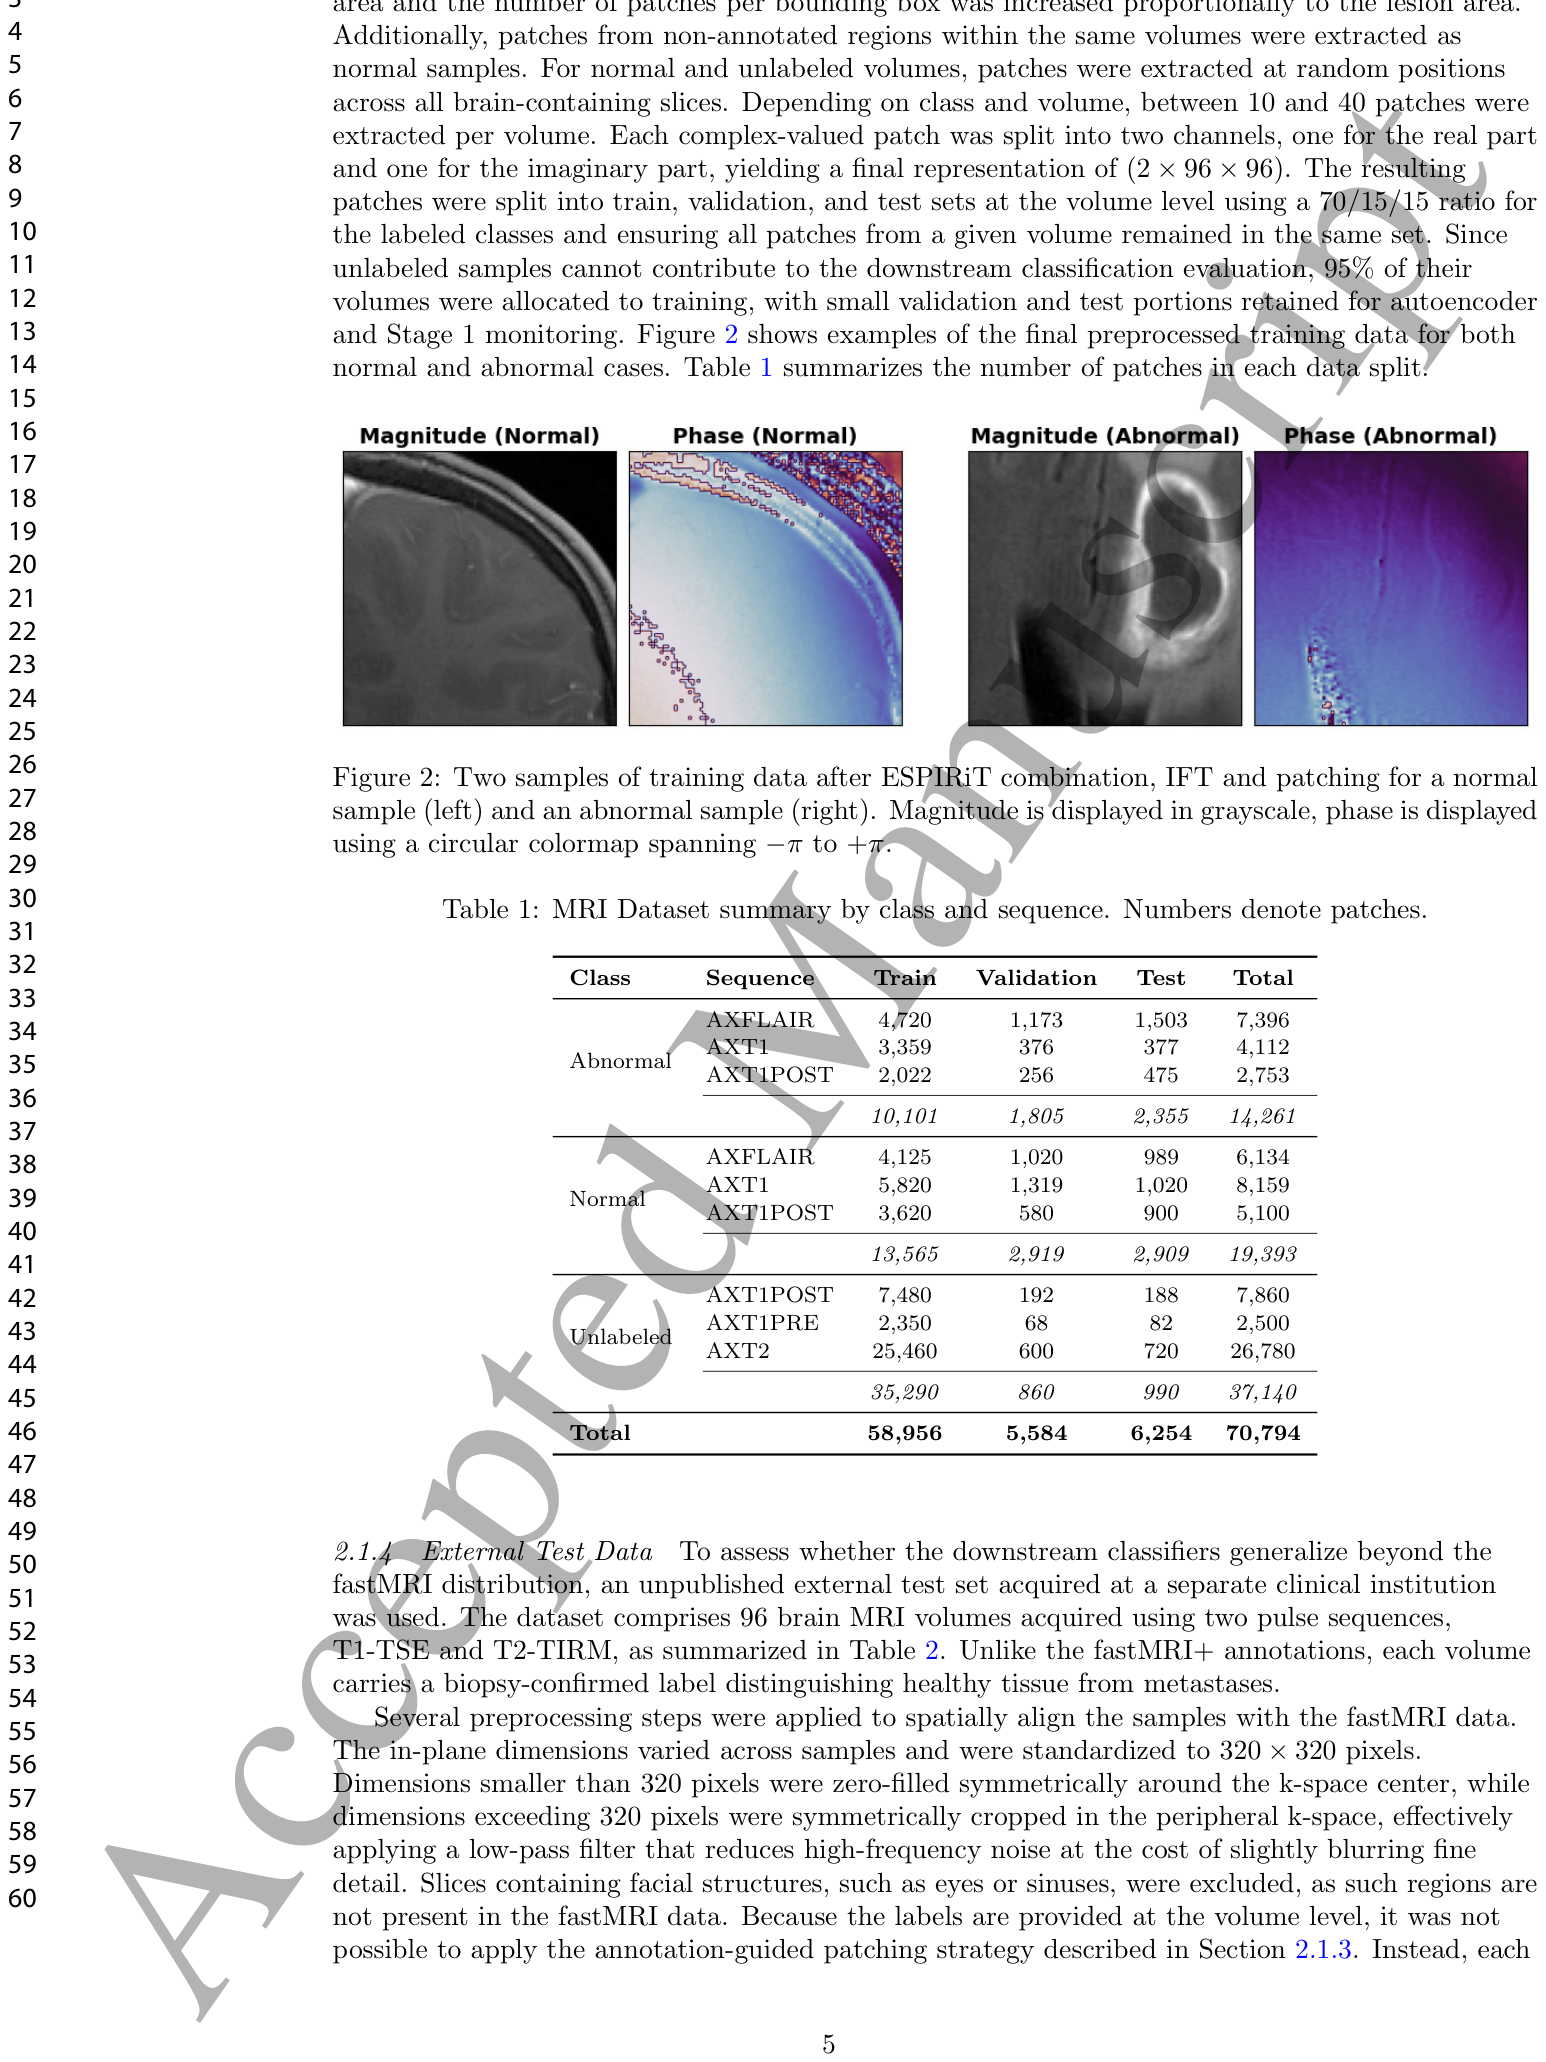
このデータセットは、AXFLAIR、AXT1、AXT1POST、AXT1PRE、AXT2の5つの取得プロトコルを指定するラベルを提供しています。異常領域をマークするバウンディングボックスの形式の対応するアノテーションはfastMRI+データセットから取得されました。これらのアノテーションは、多くの偶発的または非特異的な画像所見を含む多様なセットをカバーしており、生検で確認された最終診断にはリンクされていません。トレーニングデータの準備には、これらのボリュームから2Dパッチ(96 × 96ピクセル)を抽出しました。これは、完全なMRIスキャンを処理するのではなく、病理学的領域が各パッチの大部分を占めながら、十分な周囲の解剖学的構造を保持し、トレーニング中に診断に関連する特徴を強調するためです。外部テストセットとして、別の臨床施設で取得された96の脳MRIボリュームからなる未公開のデータセットが使用されました。
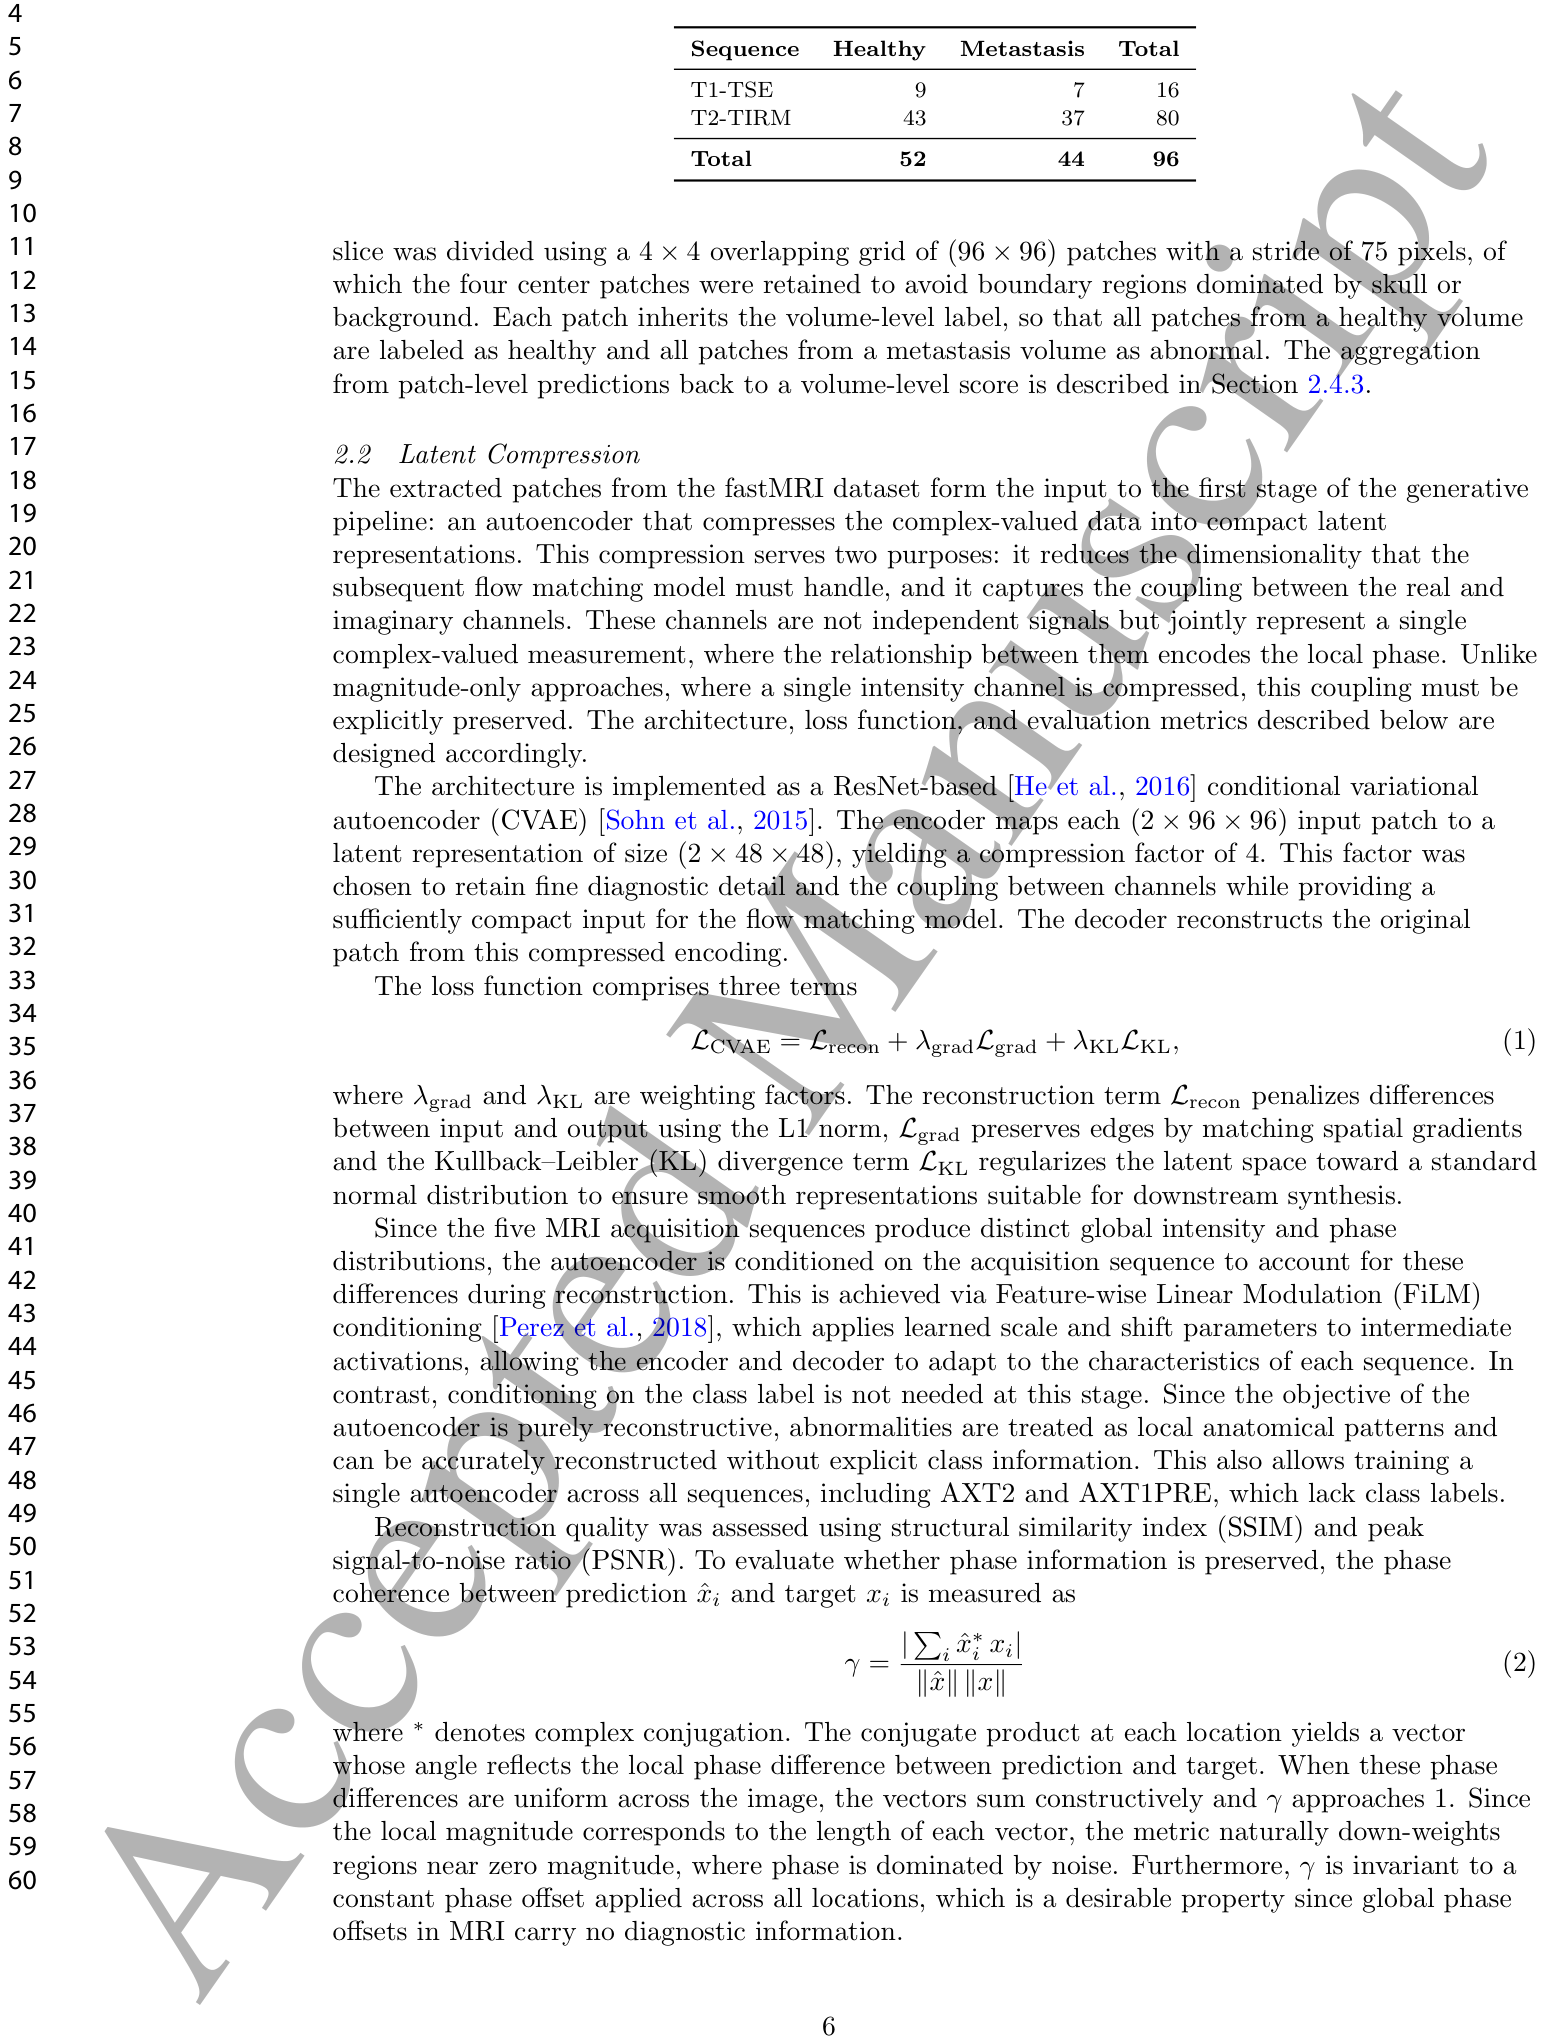
fastMRI+アノテーションとは異なり、各ボリュームには健康な組織と転移を区別する生検で確認されたラベルが付いています。
生成モデルの性能評価
2段階のトレーニングアプローチにより、取得シーケンスと異常ラベルに条件付けされた複雑数値MRIの潜在表現を合成できる生成モデルが得られます。これらのサンプルを定量的に評価するため、フローマッチングパイプラインの各段階で分類器ベースの実験が実施されました。第1段階の後、分類器は潜在空間およびデコードされた画像空間で実サンプルと合成サンプルを区別するようにトレーニングされ、生成された分布が実際のデータ分布とどれだけ一致するかを測定しました。第2段階の後、分類器は正常組織と異常組織を分離するという下流タスクでトレーニングされました。
リアルさの評価:実画像との区別不能性
確立された分類器が実サンプルと合成サンプルを確実に区別できない場合、これは生成された分布が実際の分布に密接に一致しているという証拠となります。実画像と合成画像を区別する分類器によるAUROC値の結果は、潜在空間とデコードされた画像空間(マグニチュード、位相、実数-虚数成分)で示されています。
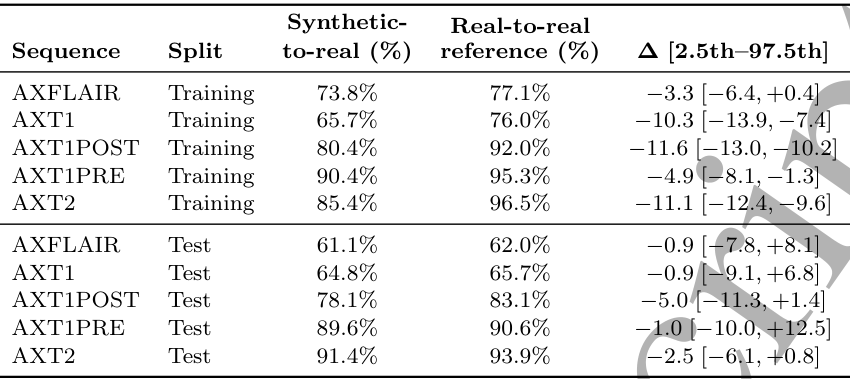
位相のAUROCは、取得シーケンス全体で0.529から0.643の範囲であり、実画像と合成された位相画像の分離が限定的であることを示し、現実的な位相モデリングの証拠を提供しています。マグニチュードのAUROCは、AXFLAIR、AXT1、AXT1POST、およびAXT2で0.766から0.820の範囲であり、より大きな分離性とシーケンス依存の分布シフトを示しています。AXT1PREは、マグニチュードのAUROCが0.528を含む、すべての表現で低いAUROCを示しましたが、これらの結果は、そのサンプルサイズがかなり小さいことを考慮して慎重に解釈する必要があります。全体として、生成された分布と実際の分布はかなり重複しており、位相で最も近い一致が観察され、マグニチュードではより大きなシーケンス依存の違いが見られました。また、生成モデルがトレーニング画像に存在する様々な特徴のほとんどを自身の学習された分布で捉えることができるかを評価するために、「画像空間カバレッジ」を測定しました。第1段階の画像空間カバレッジの結果では、生成されたサンプルは5つの取得シーケンスすべてでかなりの、しかしシーケンスに依存したカバレッジを達成しました。保持されたテスト分割では、すべてのペア差区間にゼロが含まれており、参照との間に一貫した方向差がないことを示しています。第2段階の画像空間カバレッジの結果は、全体的に実質的なカバレッジを示し、いくつかの条件依存の違いがありました。正常なトレーニング条件では、実データに一致する参照と比較してわずかなカバレッジ不足が見られた一方、異常条件のカバレッジはそれぞれの参照に近いかそれ以上でした。保持されたテスト分割では、すべての区間にゼロが含まれており、参照との間に一貫した方向差がないことを示しています。
診断への応用:異常組織検出の改善
前述の評価は分布の忠実度とカバレッジを評価するものですが、下流分類は、合成サンプルがモデルが第2段階で学習する正常組織と異常組織間の診断上関連する違いを保持しているかどうかを評価します。これを評価するために、合成された潜在表現が生成され、オートエンコーダを使用して画像領域にデコードされ、(2 × 96 × 96)サイズの合成パッチが得られます。下流のバイナリ分類器は、このデコードされたデータ上で正常パッチと異常パッチを区別するようにトレーニングされ、その性能は、デコードステップによって導入されたアーティファクトを含む完全な合成パイプラインを反映します。合成データの診断上の有用性を評価するために、2つの補完的な実験が実施されました。1つ目は、合成サンプルが実際のラベル付きデータを効果的に置き換えることができるかどうかを問い、2つ目は、完全な実際のトレーニングセットと一緒に使用された場合に、追加の価値を提供できるかどうかを調査します。代替実験(Substitution Experiment): fastMRIテストセットでの代替実験の下流分類AUROCを図に示します。
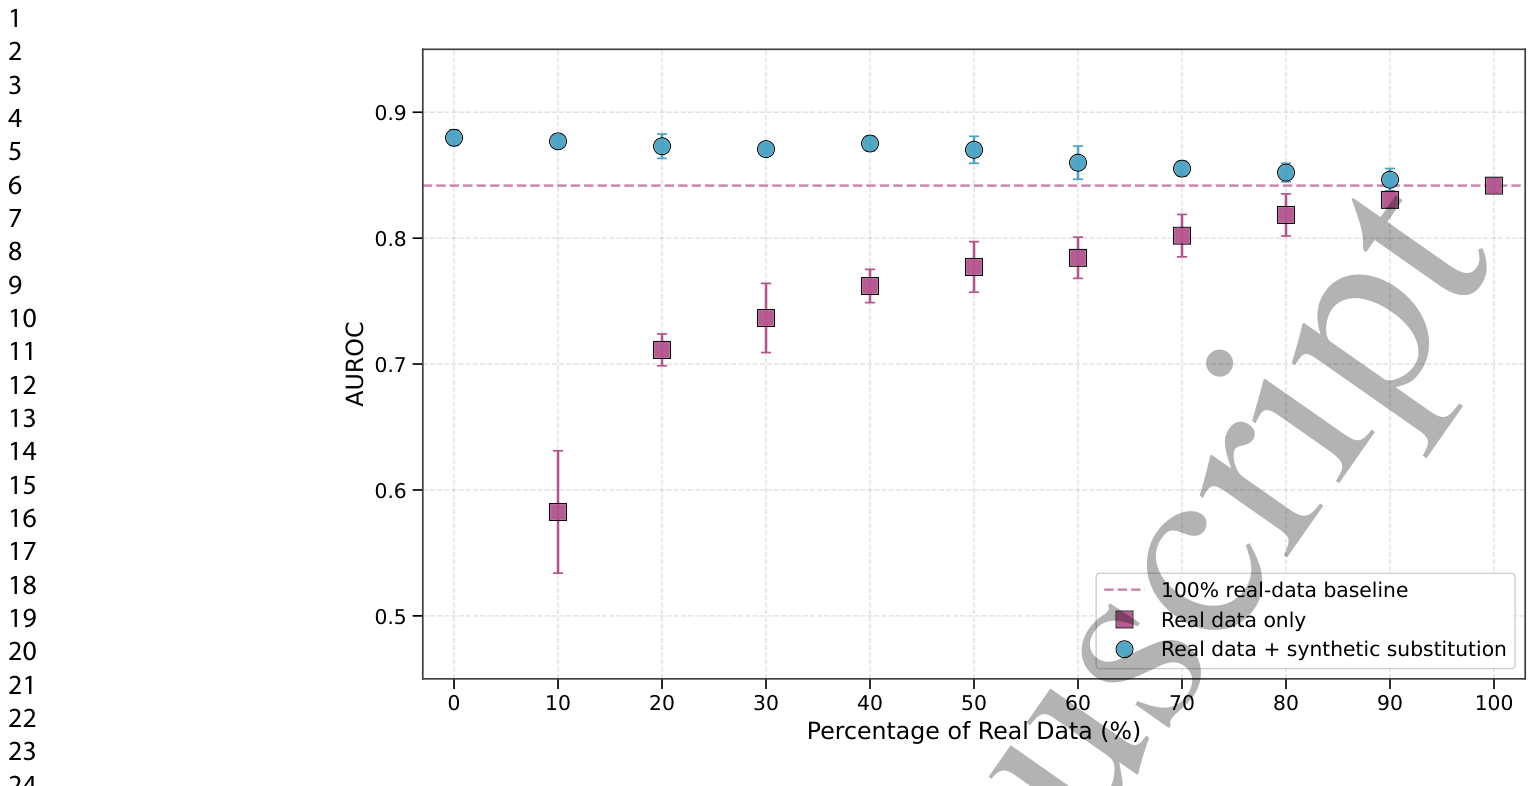
100%実データベースラインは0.842 ± 0.006のAUROCを達成しました。実サンプルを合成データで置き換えることで、対応する削減された実データ条件と比較してだけでなく、100%実データベースラインと比較しても、あらゆる構成でAUROCの改善が得られました。特に、完全に合成データでトレーニングされた構成(実データ0%)が最高の0.880 ± 0.006のAUROCを達成し、トレーニングセット内の合成データの割合が大きいほど性能が高くなる傾向があります。100%合成条件が100%実データベースラインを上回る改善は統計的に有意でした。同様の傾向は外部テストセットでも観察され、
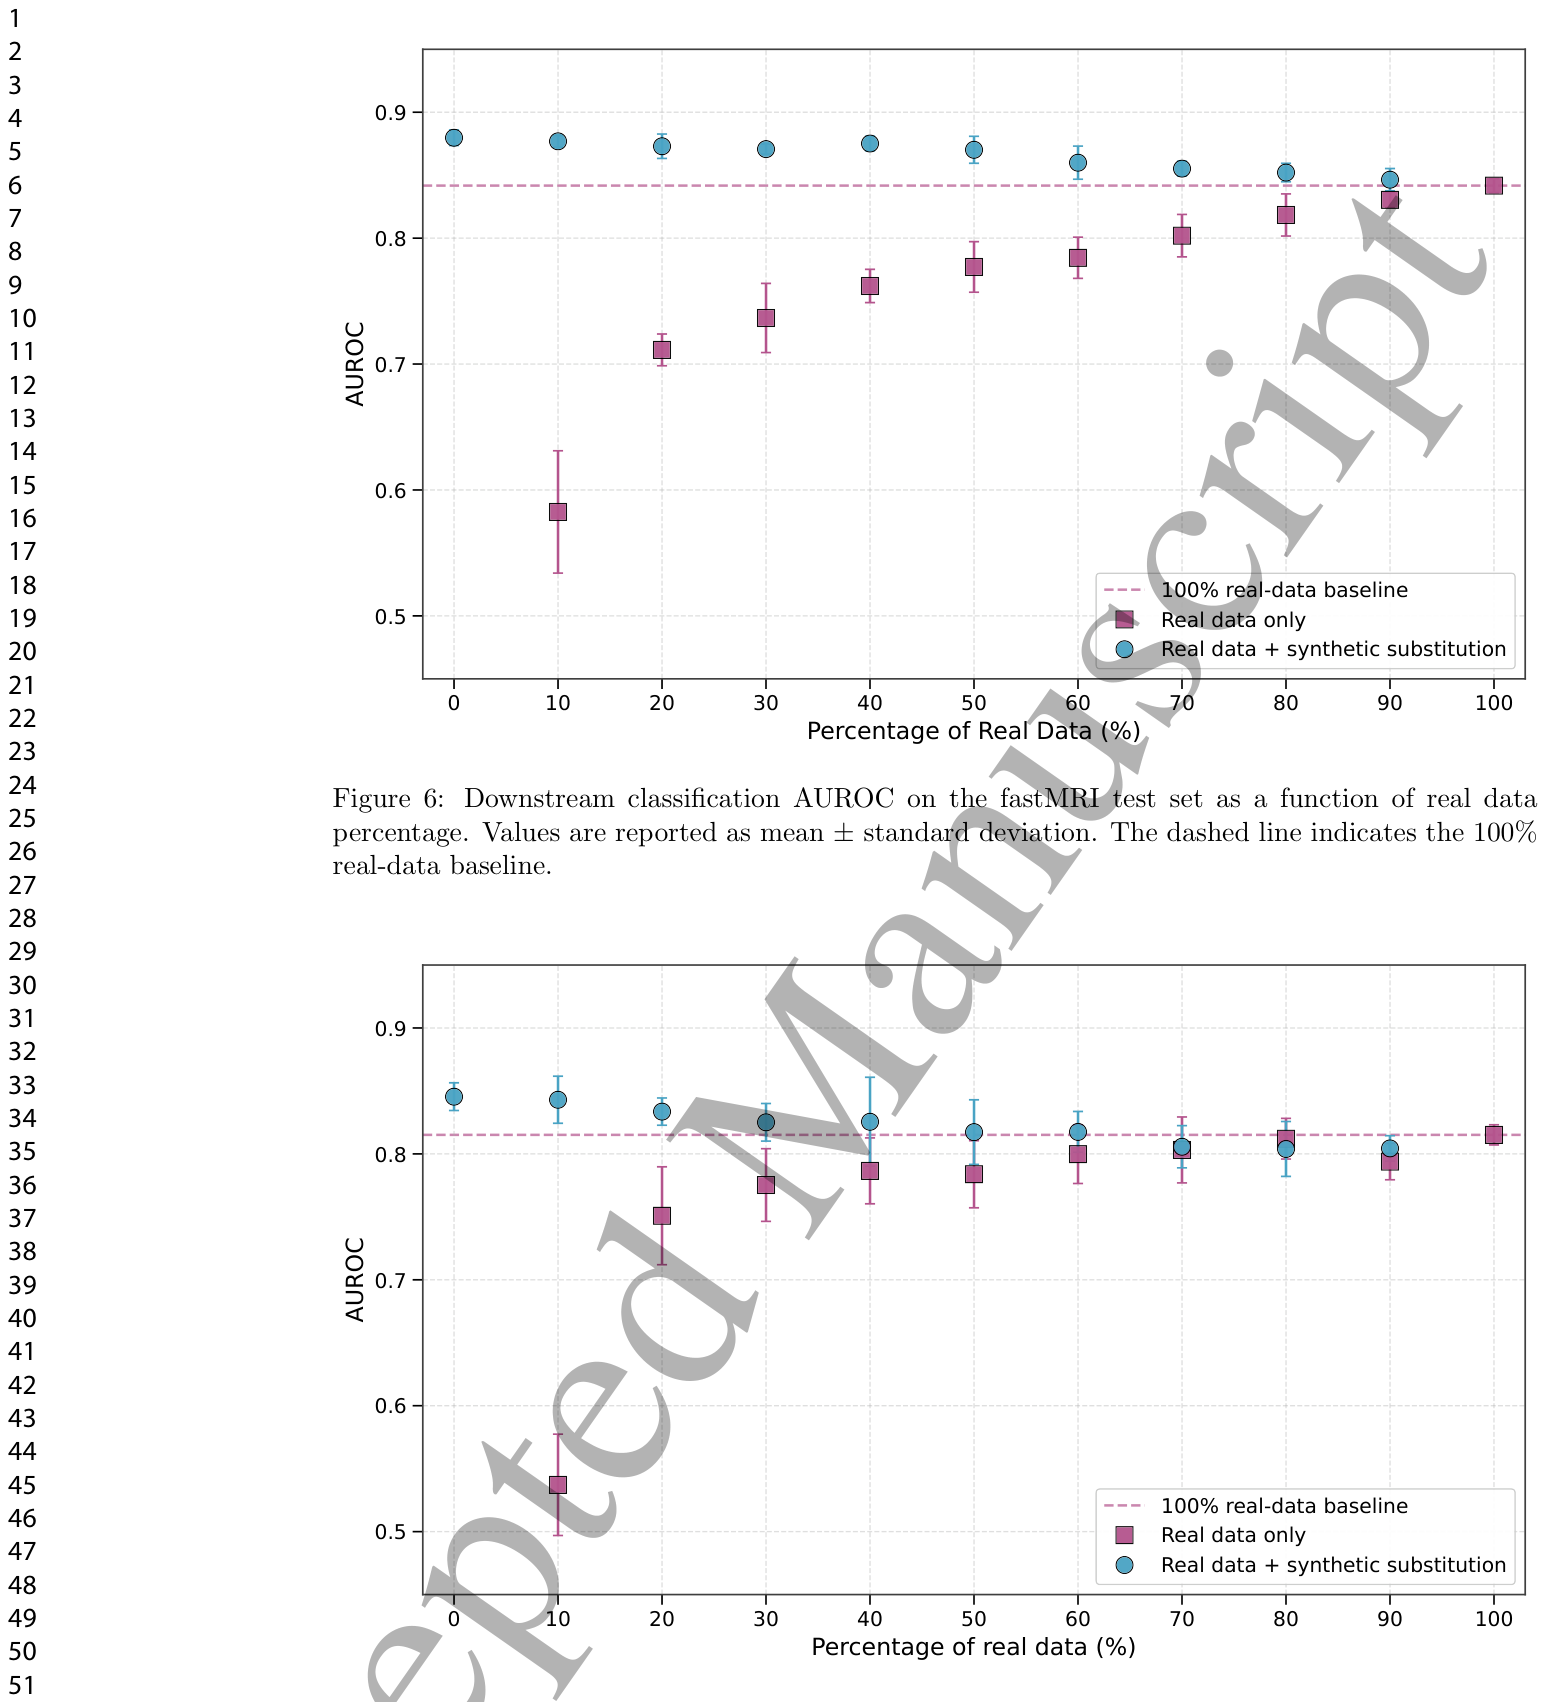
ここでも最高のAUROCである0.843 ± 0.019は、完全に合成された構成によって達成されました。実データの割合が増加するにつれて性能は低下し、50%実データと50%合成データの構成でベースライン0.815 ± 0.008に近づきました。この点を超えると、その後の構成はわずかにベースラインを下回りました。追加実験(Additive Experiment): 完全な実際のトレーニングセットに合成データを徐々に追加していく追加実験の結果を図に示します。
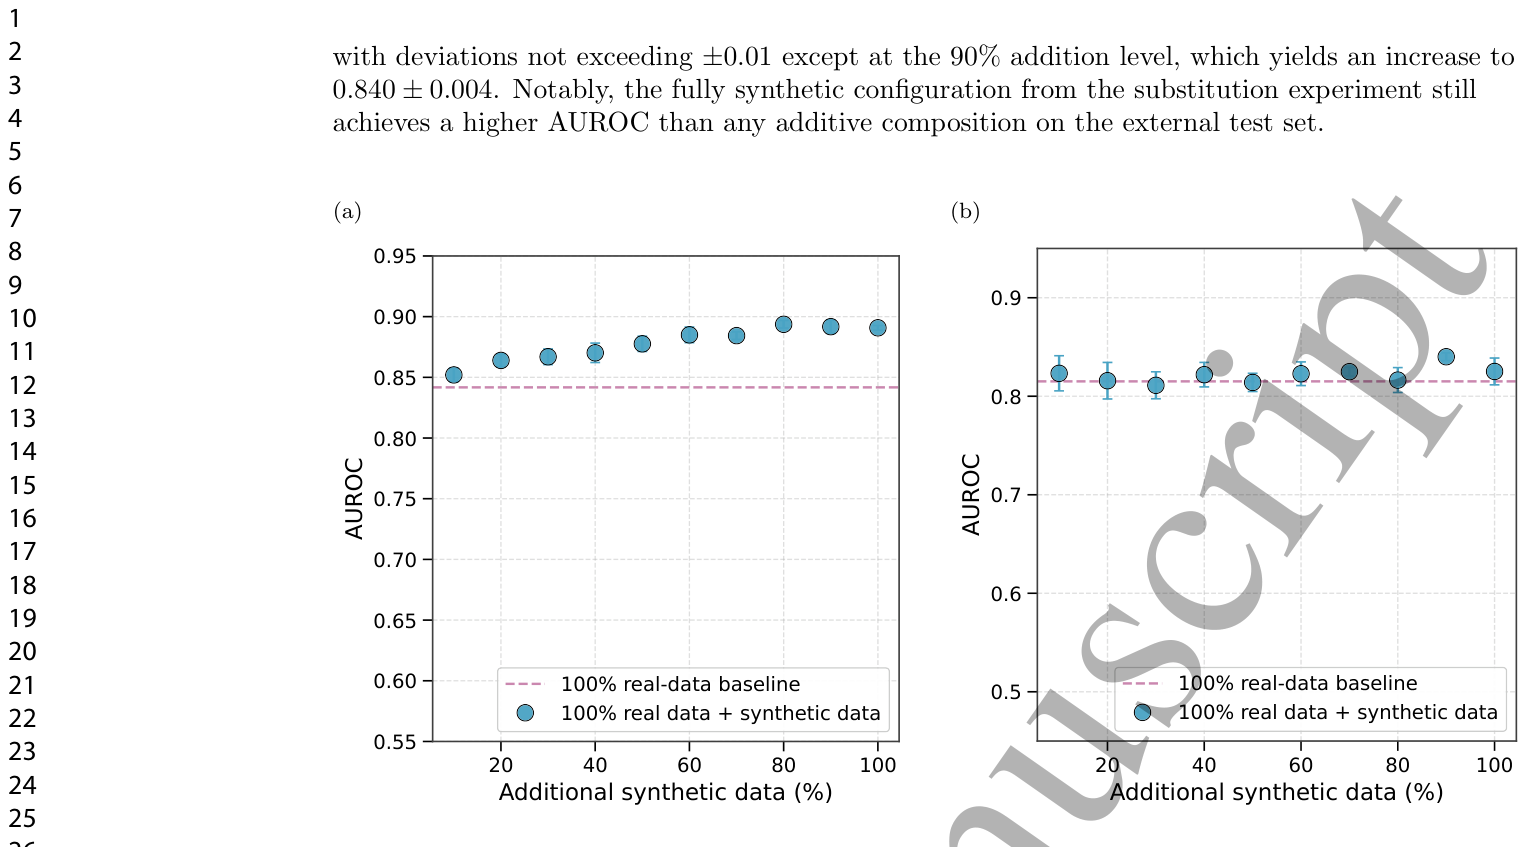
fastMRIテストセットでは、ベースラインの0.842 ± 0.006から着実に性能が向上し、80%の追加合成データを含めた場合に0.894 ± 0.003に達しました。この時点でAUROCは飽和し、さらなる合成データは追加の利益をもたらしませんでした。比較すると、この上昇傾向は外部テストセットでは観察されず、0.815 ± 0.008の100%実データベースラインに近い性能を維持しました。例外として、90%追加レベルで0.840 ± 0.004に増加しました。注目すべきは、代替実験の完全に合成された構成が、外部テストセットでの任意追加構成よりも依然として高いAUROCを達成していることです。
研究の意義と今後の展望
本研究の主な貢献は、この生成フレームワークそのものです。著者らが知る限り、先行研究において、生成設定で完全なMRI取得からマグニチュードと位相情報の両方を共同でモデル化するものはこれまでありませんでした。このフレームワークは、正常および異常な複雑数値脳MRIデータのマグニチュードと位相情報を共同でモデル化する実現可能性を実証しています。合成データ生成を超えて、このフレームワークは、将来的により大規模で、病理学的に詳細な、病理が確認された生のMRIデータセットが利用可能になった際に、マグニチュードと位相がどのように病理特異的な特徴を共同でエンコードするかを調査することを可能にします。これにより、現在のMRI診断の限界を克服し、対象者にとってより安全で正確な診断へとつながる可能性が期待されます。
補足図表
Figure 2
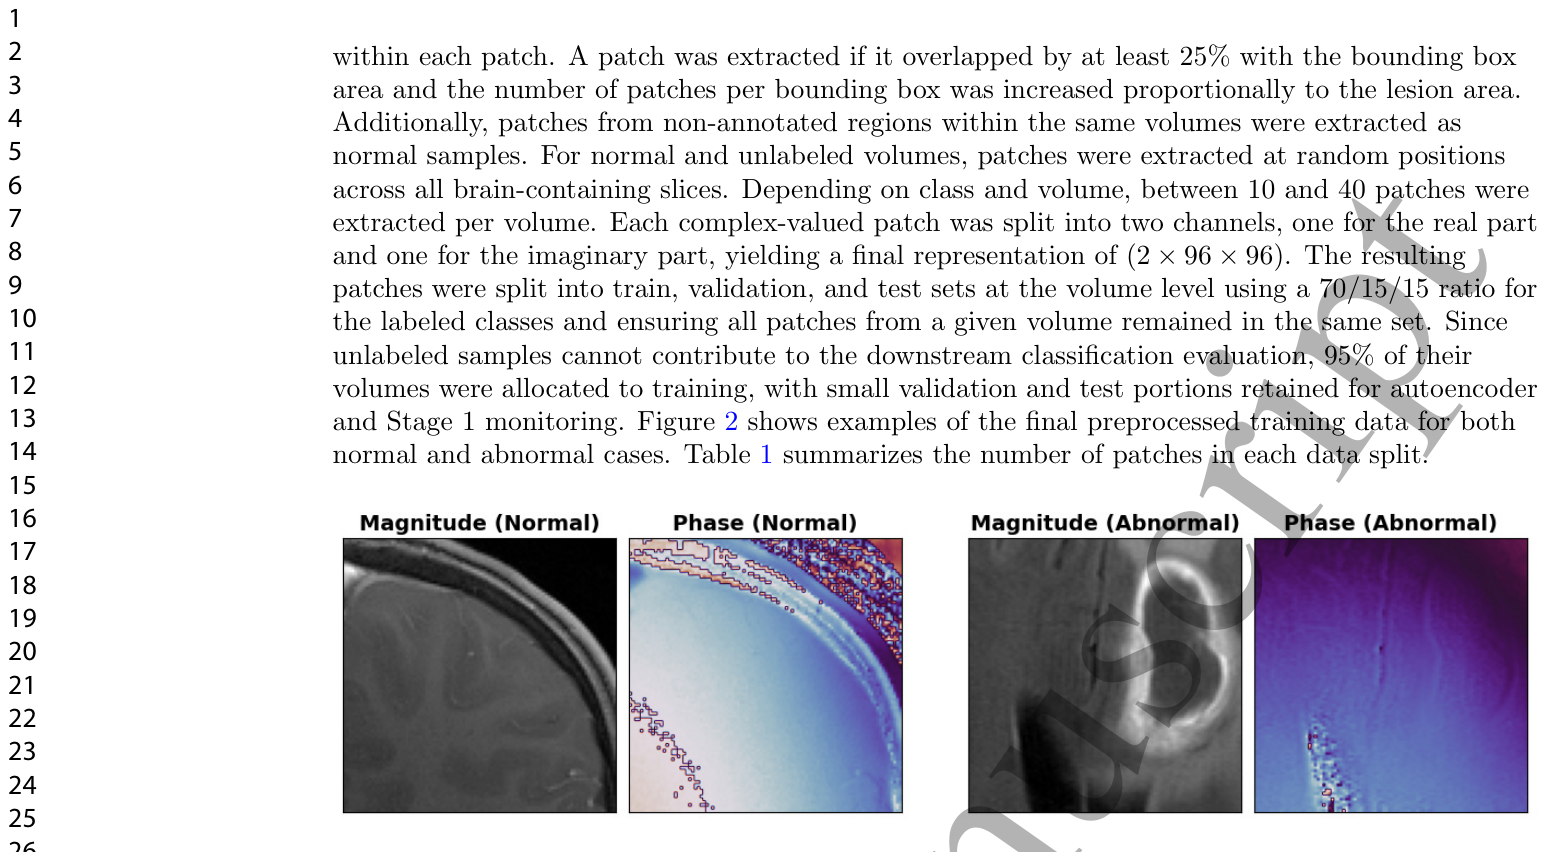
Figure 9
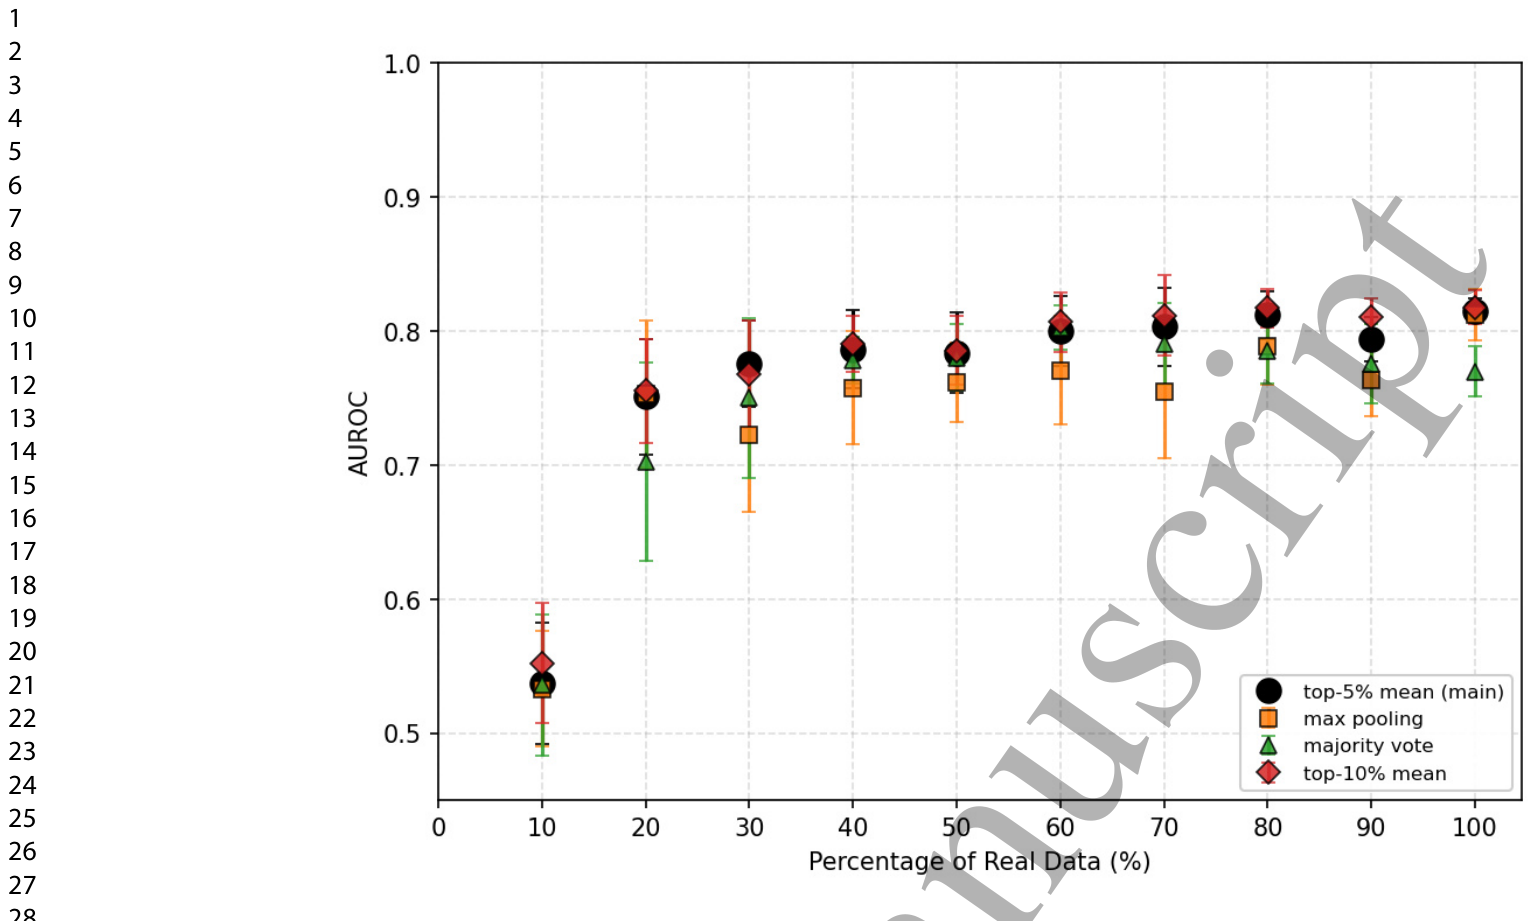
Figure 10
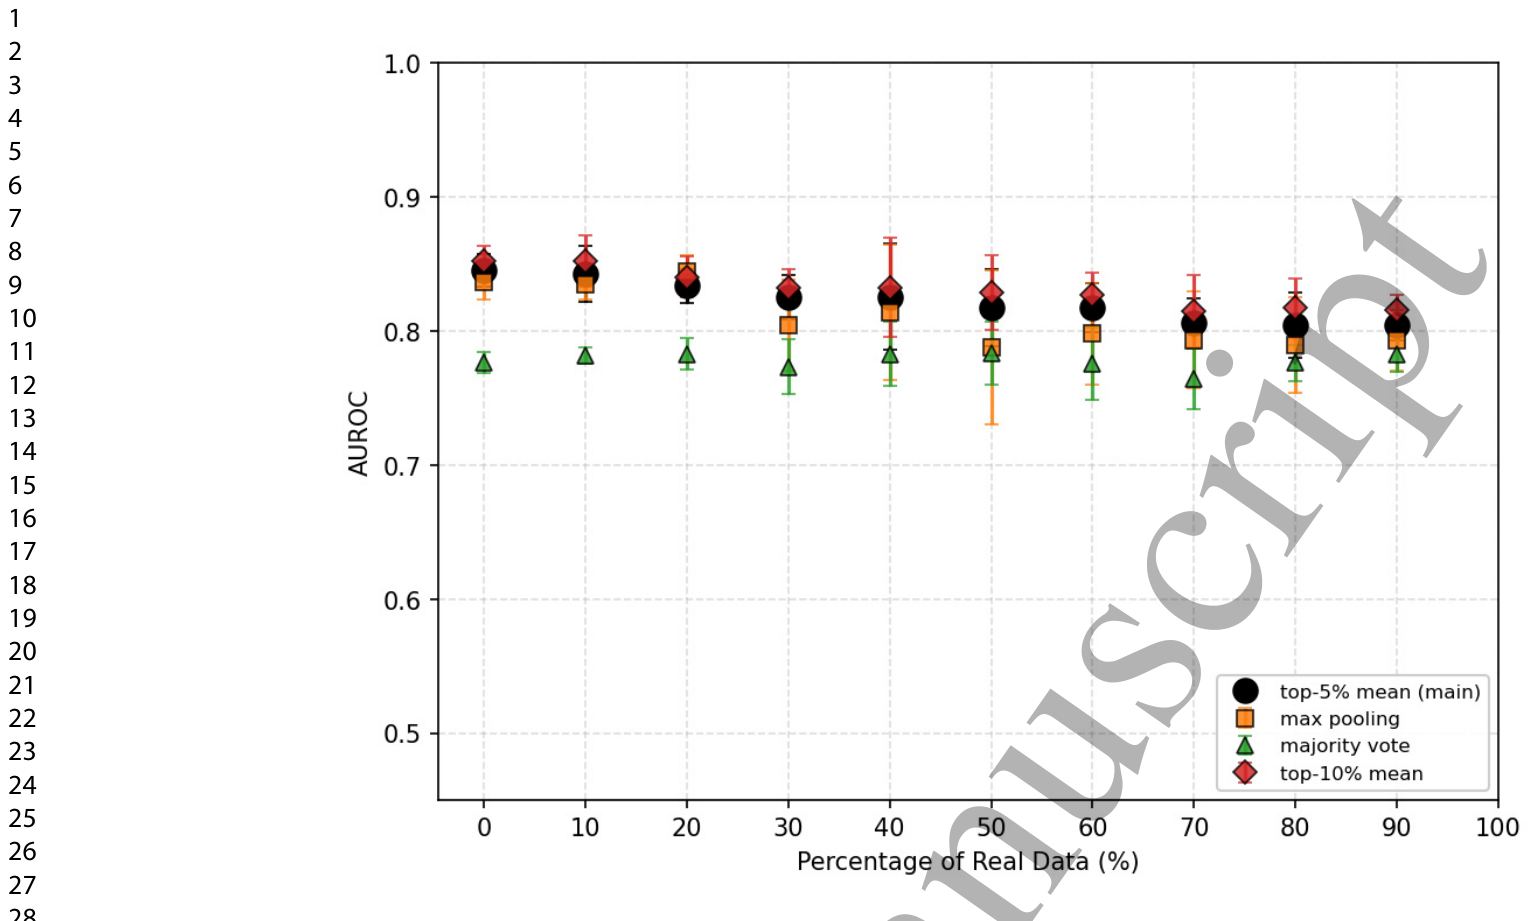
Figure 11
Figure 12
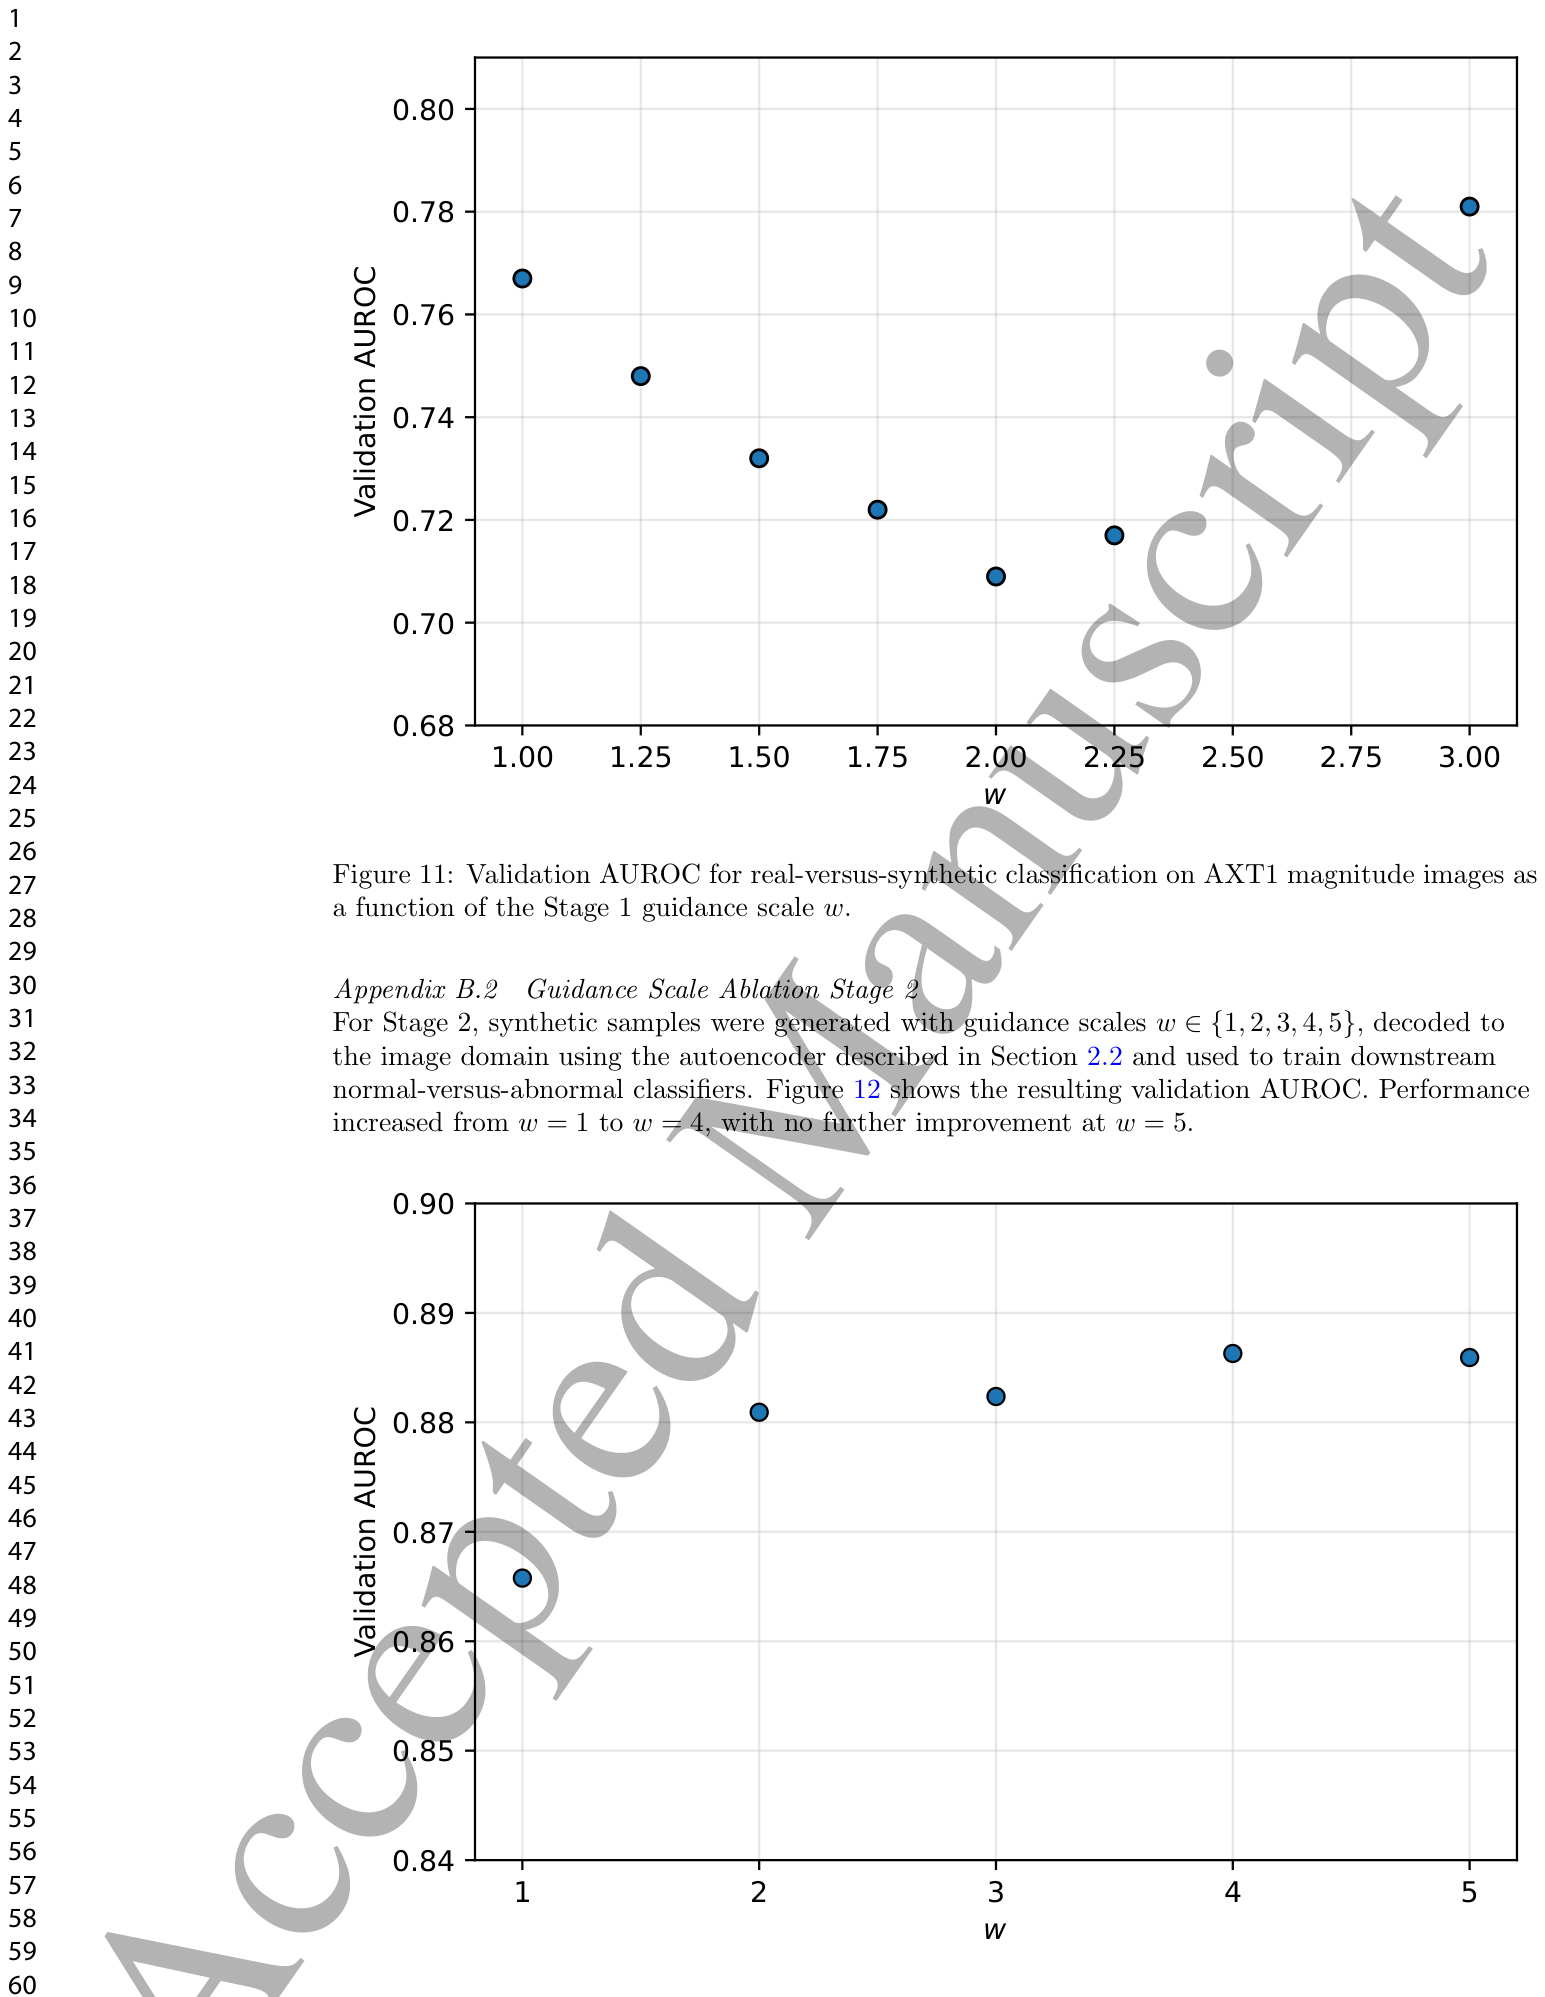
Figure 13
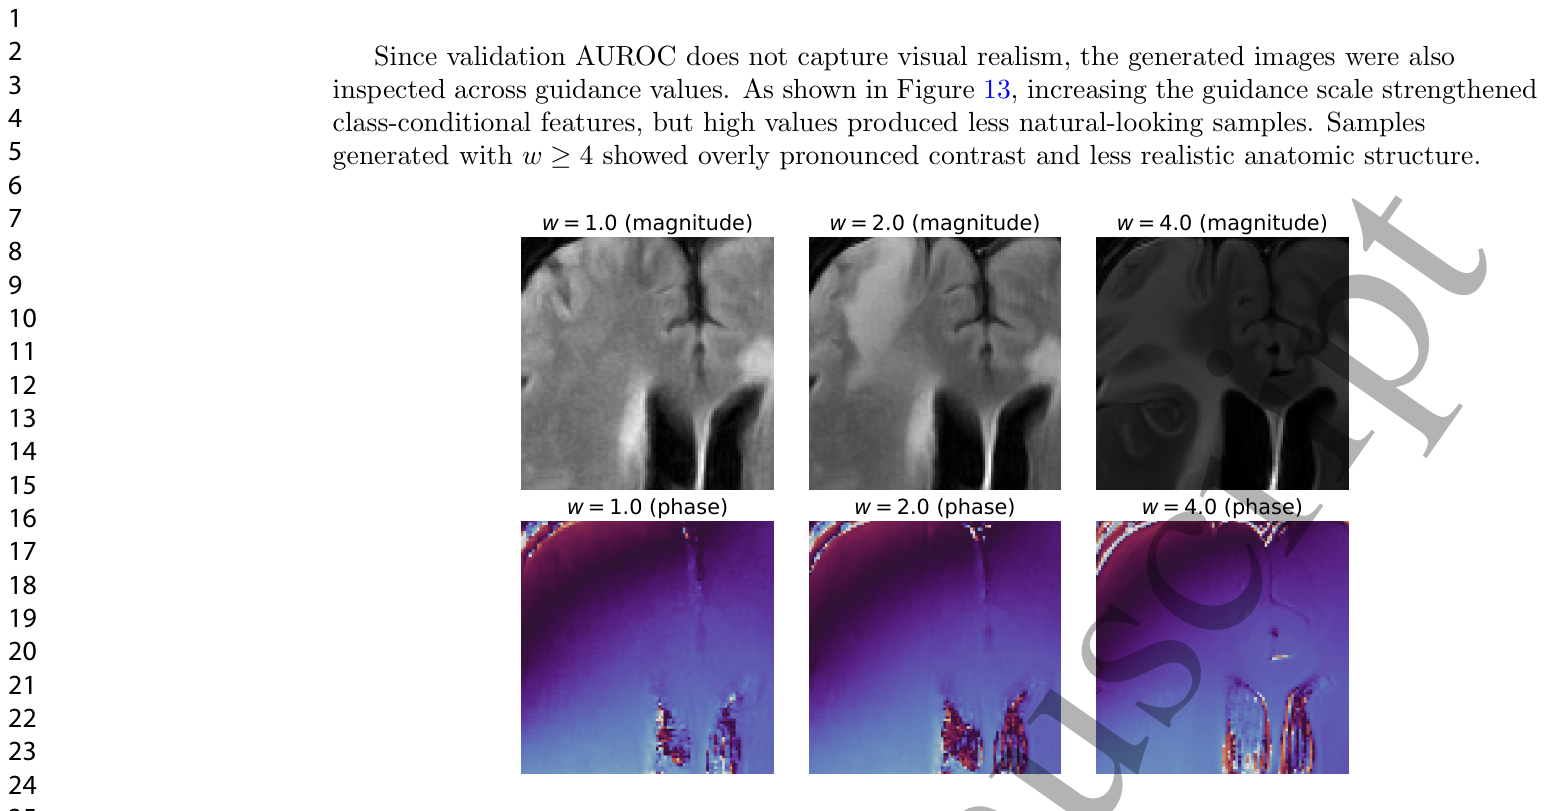
Figure 14
用語集
- MRI: 磁気共鳴画像診断。強力な磁場と電波を用いて体内の詳細な画像を生成する技術。
- k空間: MRIスキャナが信号を収集する生のデータ領域。画像の周波数成分を保持する。
- 位相情報: MRI画像が持つ、組織の磁気特性に敏感な情報。標準的な再構成で失われがち。
- マグニチュード情報: MRI画像が持つ、組織の強度を示す情報。一般的に視覚化される部分。
- 複雑数値データ: 実部と虚部で構成されるデータ。MRIの生データや、再構成後の画像データがこれに該当。
- オートエンコーダ: 入力データを圧縮された潜在表現に変換し、そこから元のデータを再構築するニューラルネットワーク。
- フローマッチングモデル: 生成モデルの一種で、ノイズからクリーンなデータを生成する過程の「速度」を学習し、新しいデータを合成する。
- AUROC: 受信者動作特性曲線下面積。分類モデルの性能を評価する指標で、値が高いほど性能が良い。
- 合成データ: 生成モデルによって人工的に作成されたデータ。トレーニングデータとして利用できる。
- 潜在空間: ニューラルネットワークが入力データから学習し圧縮した、より抽象的な特徴表現の空間。
- CVAE: 条件付き変分オートエンコーダ。入力データだけでなく、特定の条件(例:MRIシーケンス)に基づいてデータを生成・再構築するオートエンコーダ。
- SSIM: 構造類似度指数。2つの画像の類似性を人間の視覚に基づいて評価する指標。
- PSNR: ピーク信号対雑音比。画像や動画の品質を評価する指標で、元の画像と再構成された画像間のノイズレベルを示す。
- 位相コヒーレンス: MRIの予測画像と実際の画像間で、位相情報がどれだけ一貫して保持されているかを示す尺度。
コメントを残す