
PET単独で腫瘍を自動判別?データ中心深層学習によるセグメンテーションの最前線
解説対象論文: Fully Automated Segmentation of [ 18 F]FDG and [ 68 Ga]/[ 18 F]PSMA PET/CT Images via Data-Centric Deep Learning
Journal of Nuclear Medicine|被引用数: 0(2026年10月2日時点)
がんの画像診断において、PET/CT検査は腫瘍の検出と評価に不可欠です。しかし、腫瘍領域の手動セグメンテーションは時間と労力がかかり、臨床現場での課題となっていました。本記事では、この課題を克服するために開発された、PET画像単独で高精度な腫瘍セグメンテーションを可能にするオープンソースツール「LION」について解説します。特に、CT情報を活用して解剖学的コンテキストを学習する独自のデータ中心的アプローチと、トレーニングデータの多様性がセグメンテーション性能に与える影響に焦点を当てます。
はじめに:がん診療におけるPET/CTの役割と課題
どうも、Beyond the Pixelです。がんの診断や治療効果の評価において、PET/CT検査は非常に重要な役割を担っています。特に、[18F]FDG PET/CTは様々な種類のがんに、PSMA標的PET/CTは前立腺がんに広く用いられています。これらの画像から腫瘍の領域を正確に特定する「腫瘍セグメンテーション」は、腫瘍量や薬剤の集積度を定量的に評価するために不可欠です。しかし、手作業でのセグメンテーションは時間がかかり、特に転移が広範囲に及ぶ対象者の場合、日常の診療で実施するのは困難です。これが、PET画像バイオマーカーを臨床に導入する上での大きなボトルネックとなっていました。
既存の多くの自動セグメンテーション手法は、PET画像だけでなくCT画像も併用して解剖学的な位置情報(コンテキスト)を得ています。これは効果的ですが、CT画像の有無や品質に依存するという課題があります。では、CT情報が推論時に本当に必要なのでしょうか?トレーニングの段階で解剖学的コンテキストを学習させ、推論時はPET画像のみでセグメンテーションを行うことはできないのでしょうか?
今回ご紹介する論文では、この課題に応えるべく、「LION (Lesion Identification in Oncologic Nuclear Imaging)」というオープンソースのPET単独腫瘍セグメンテーションパイプラインを開発し、その有効性を検証しています。この研究の重要な点は、「データ中心的深層学習」というアプローチを採用していることです。これは、モデルのアーキテクチャの複雑さだけでなく、トレーニングデータの質、多様性、構造がセグメンテーション性能を決定するという考え方に基づいています。本研究では、大規模な多施設データを用いて、トレーニングデータの特性がセグメンテーション性能にどのように影響するかについても詳しく調べています。
LIONの仕組み:PET単独で解剖学的コンテキストを学習する新アプローチ
LIONは、[18F]FDGおよびPSMA標的PET/CT画像から腫瘍を自動的にセグメンテーションするためのオープンソースソフトウェアです。この研究では、大規模な多施設データセットを使用しました。具体的には、19種類の疾患タイプを含む5209件の[18F]FDG PET/CTスキャンと、2046件のPSMA標的PET/CTスキャンがトレーニングに用いられました。これらのデータは、様々な医療施設やスキャナープラットフォームから収集されており、多様な臨床状況を反映しています (
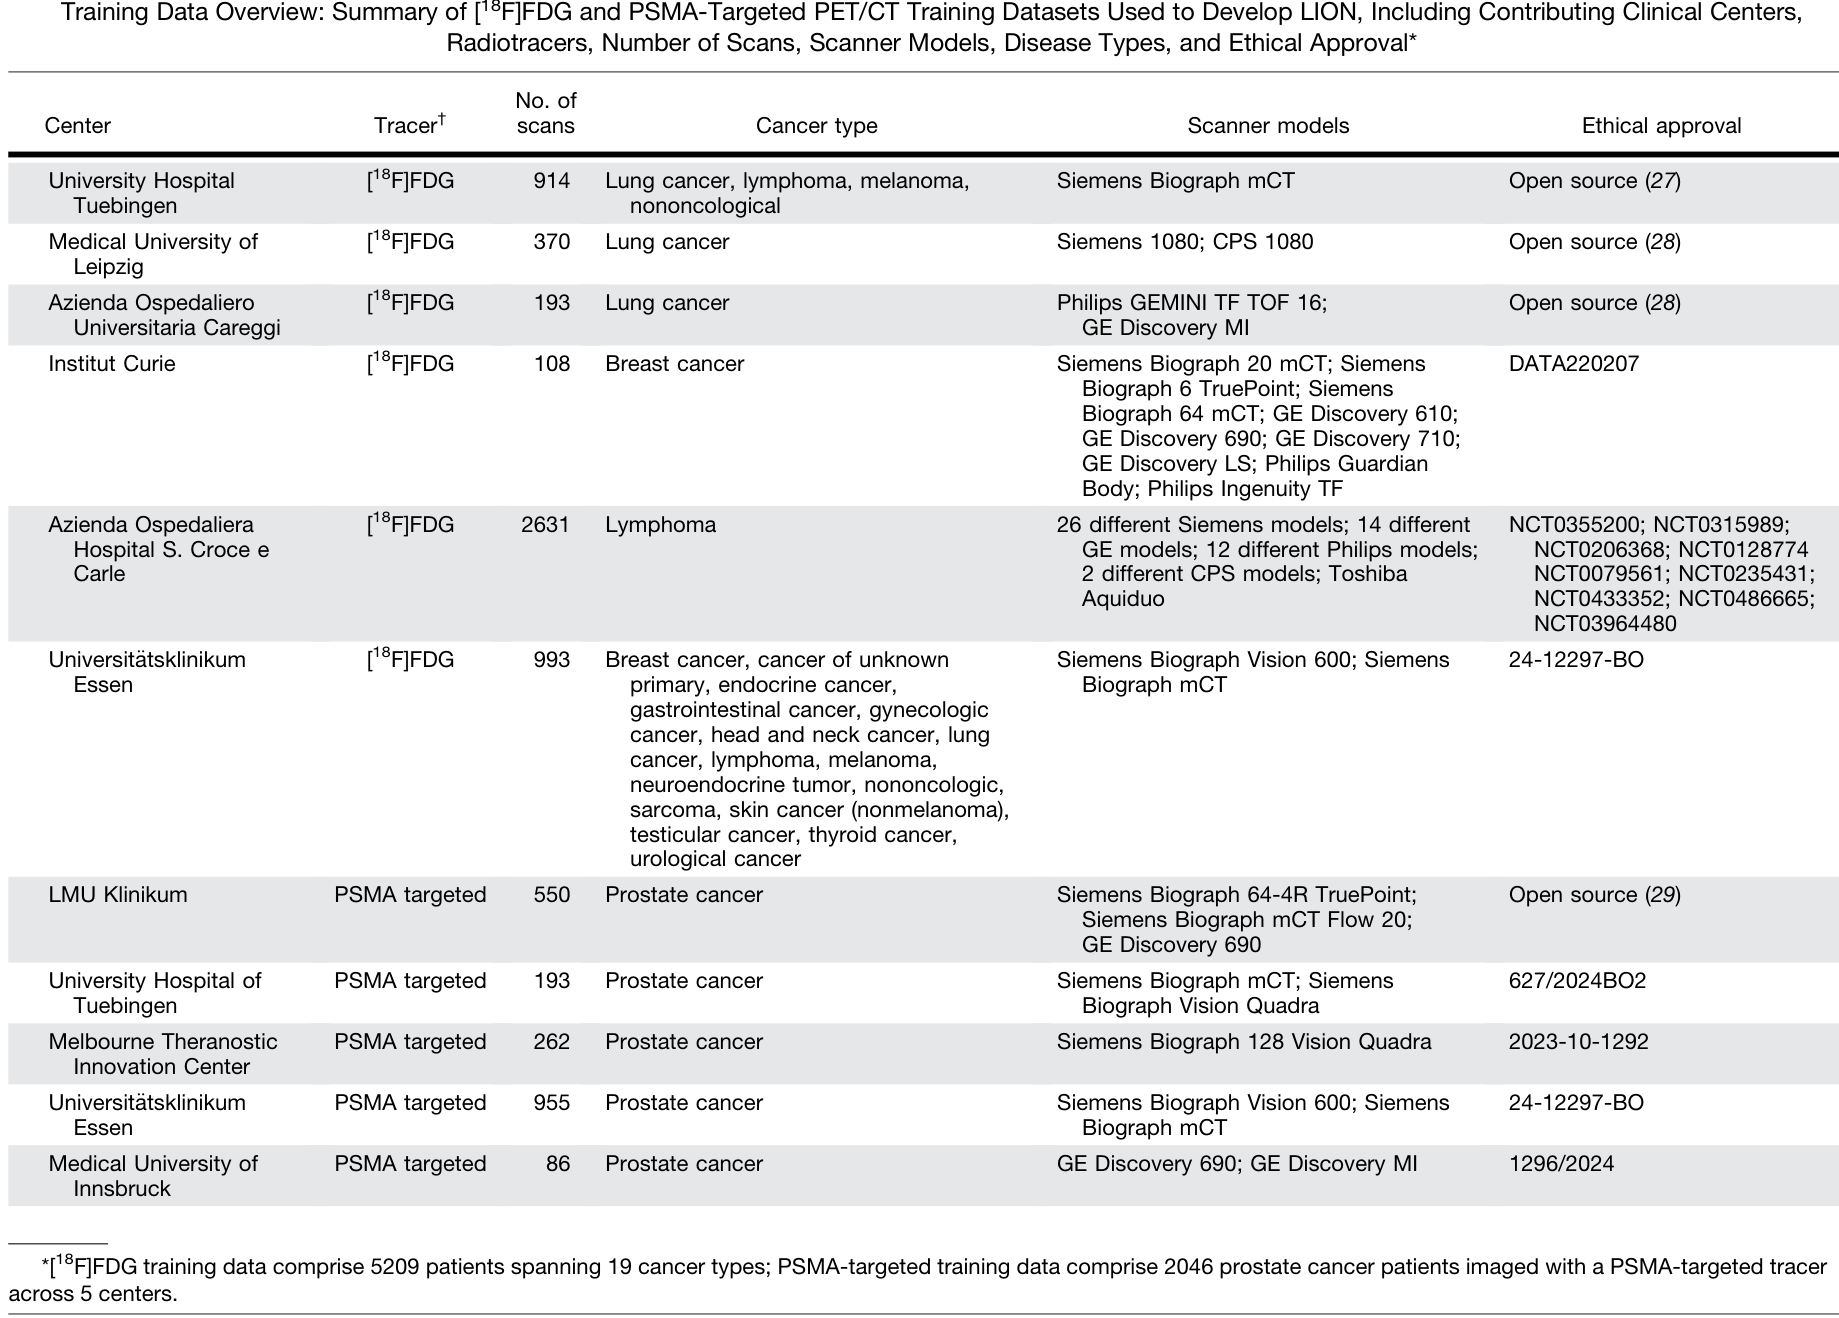
)。
LIONの主要な特徴は、PET画像のみを入力として腫瘍セグメンテーションを行う点にあります。通常、PET画像は代謝活性を示しますが、解剖学的な構造はCT画像ほど明確ではありません。そこで、LIONではトレーニング中にCT画像から得られた臓器マスクを「補助クラス」として組み込みました。これにより、ネットワークはPET画像から解剖学的コンテキストを学習することができ、推論時にはCT画像に依存することなく、PET画像単独で高精度なセグメンテーションを実現します。生理学的集積のある臓器(例:脳、肝臓、脾臓、腎臓、膀胱など)を補助クラスとして含めることで、これらの臓器における放射性薬剤の集積を腫瘍と誤認する「偽陽性」を減らすことを目指しました。
また、トレーニングデータの特性がセグメンテーション性能にどのように影響するかを分析するために、2つの重要な手法が用いられました。1つは「TOMs (Tumor Occurrence Maps)」で、これはトレーニングデータセットにおける腫瘍の空間的な分布を定量化する3次元確率マップです。もう1つは「DINOv2エンベディング」で、これは画像の特徴を捉える埋め込み表現を用いて、スキャナーやプロトコルに起因する「ドメインシフト」(トレーニングデータとテストデータの系統的な違い)を分析するために使用されました。
LIONの性能評価:多施設ホールドアウトデータでの高精度とデータの影響
LIONの性能は、トレーニングデータとは完全に独立した多施設ホールドアウトコホートで評価されました。616件の[18F]FDGスキャンと443件のPSMA標的スキャンが使用され、これらも複数の医療施設や疾患タイプをカバーしています (
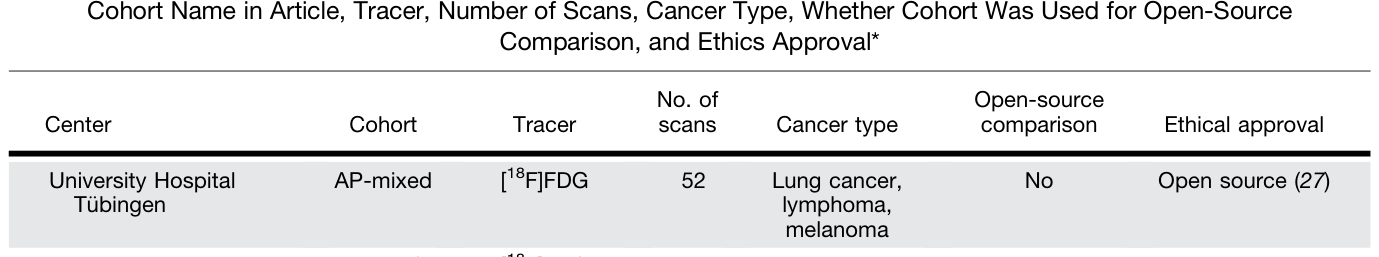
)。
1. 臓器コンテキスト導入の効果
臓器コンテキストをトレーニング中に組み込むことで、セグメンテーション精度が大幅に向上することが示されました。PET単独での腫瘍セグメンテーションにおけるDice係数(予測と実際の腫瘍領域の重なりを示す指標)は、[18F]FDGで0.62から0.71へ、PSMAで0.75から0.83へと改善しました (
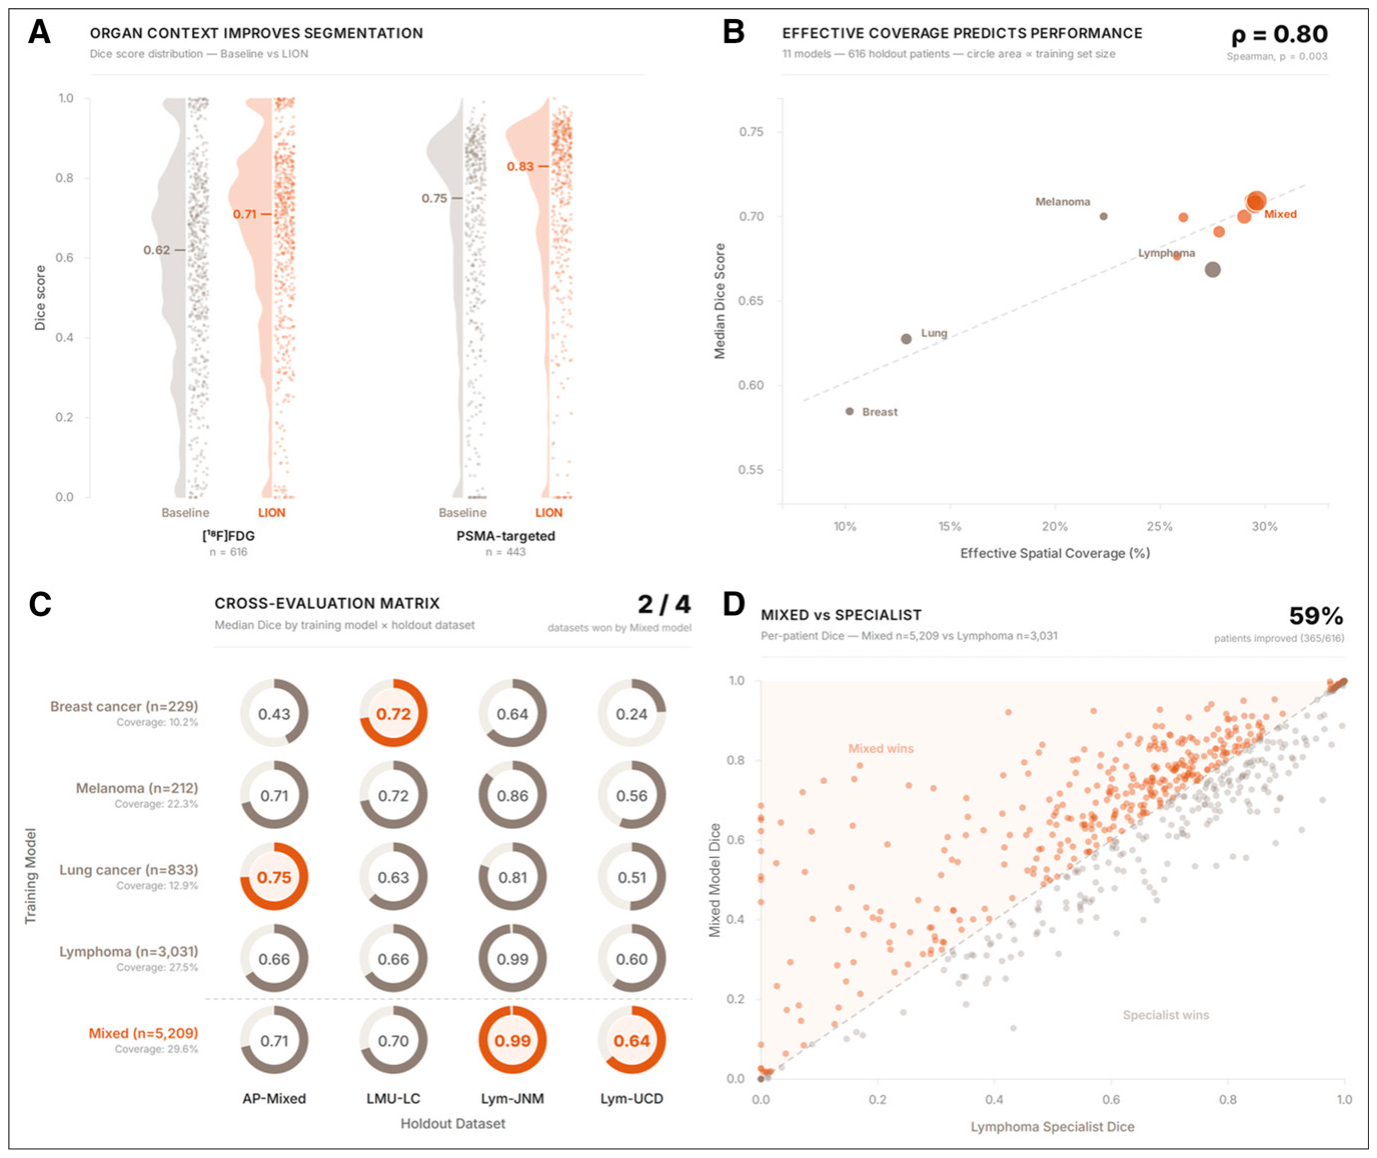
A)。この改善は主に「PPV(陽性予測値)」の向上によってもたらされ、生理学的集積のある領域での偽陽性が減少したことを示しています。
2. ホールドアウトコホートでのセグメンテーション性能
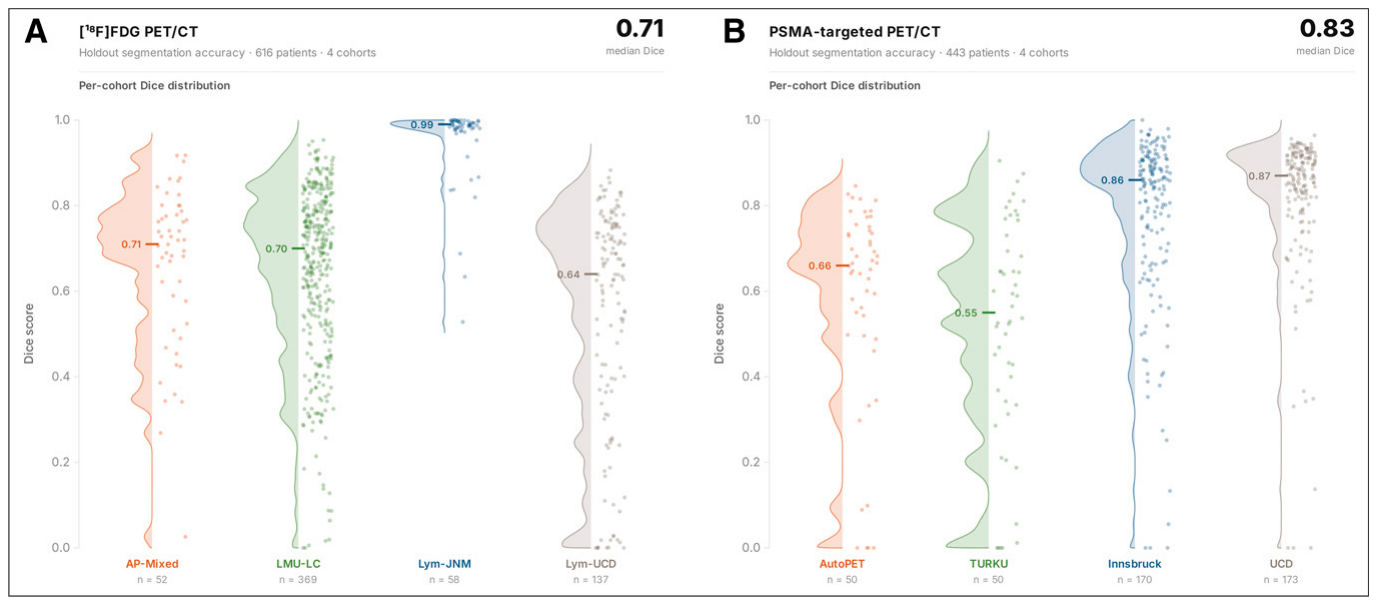
LIONは、616件の[18F]FDGホールドアウトスキャン全体で、中央値Dice係数0.71、感度0.86、PPV 0.67を達成しました。個々のコホートで見ると、Lym-JNMコホートでは0.99と非常に高いDice係数を示しましたが、Lym-UCDコホートでは0.64と相対的に低い値でした (
A)。
443件のPSMA標的ホールドアウトスキャン全体では、中央値Dice係数0.83、感度0.93、PPV 0.91を達成しました ((図2)B)。ただし、Turkuコホートでは小さな腫瘍量の対象者が多く、Dice係数が0.55と低くなる傾向が見られましたが、病変の検出感度自体は1.00と高さを維持しており、これは主に非常に小さな病変における輪郭の不正確さや偽陽性が影響している可能性が示唆されています。
特定のSUV(Standardized Uptake Value)閾値(例えばSUVが4以上)を適用して評価した場合、[18F]FDGの多くのコホートでDice係数が大幅に向上し、例えばLym-JNMコホートでは中央値0.99を維持しました。これは、評価基準の一貫性が性能評価に大きく影響することを示唆しています。
3. DINOv2エンベディングによるスキャナー関連のドメインシフト分析
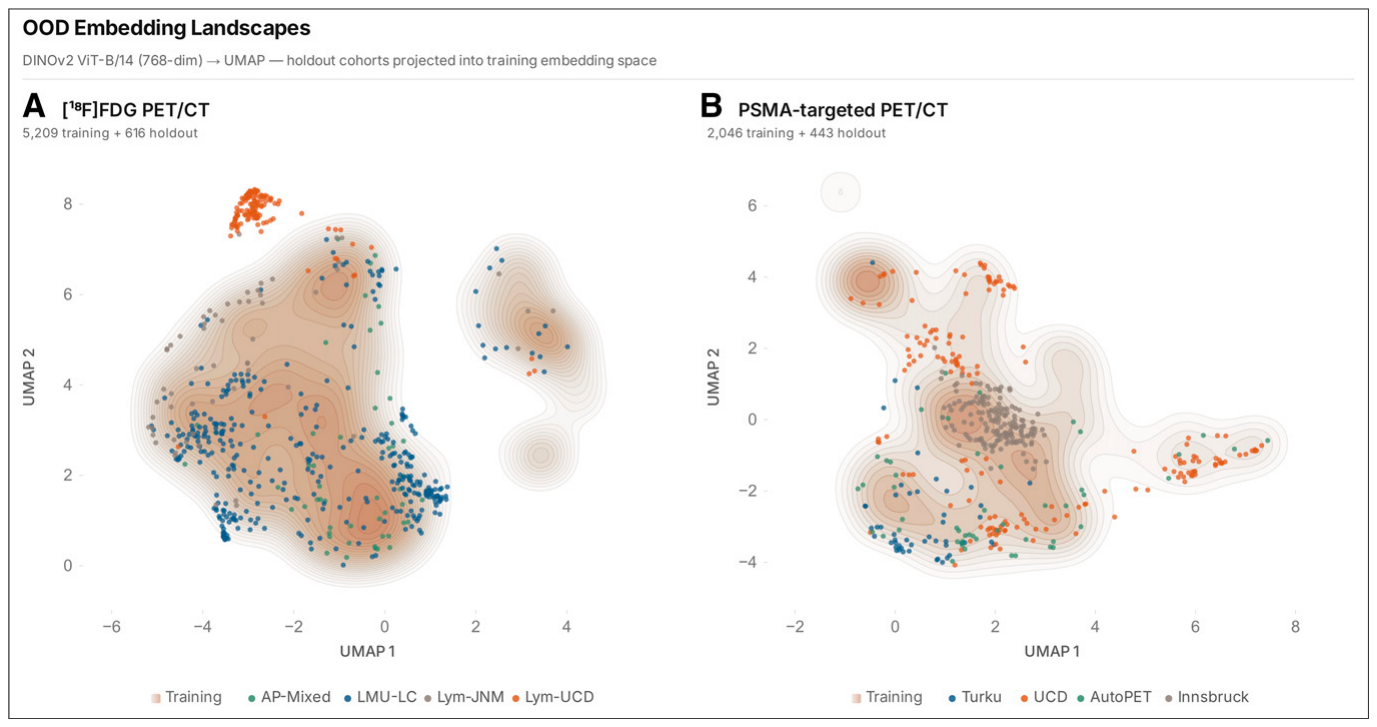
DINOv2エンベディングを用いた分析により、トレーニングデータとテストデータ間のスキャナーに起因するドメインシフトが明らかになりました。特に、Lym-UCDコホートはトレーニングデータから分離した明確なクラスターを形成しており、これがLym-JNMコホートと比較して性能が低かった原因の一部と考えられます (
)。
4. トレーニングデータ構成がセグメンテーション性能に与える影響
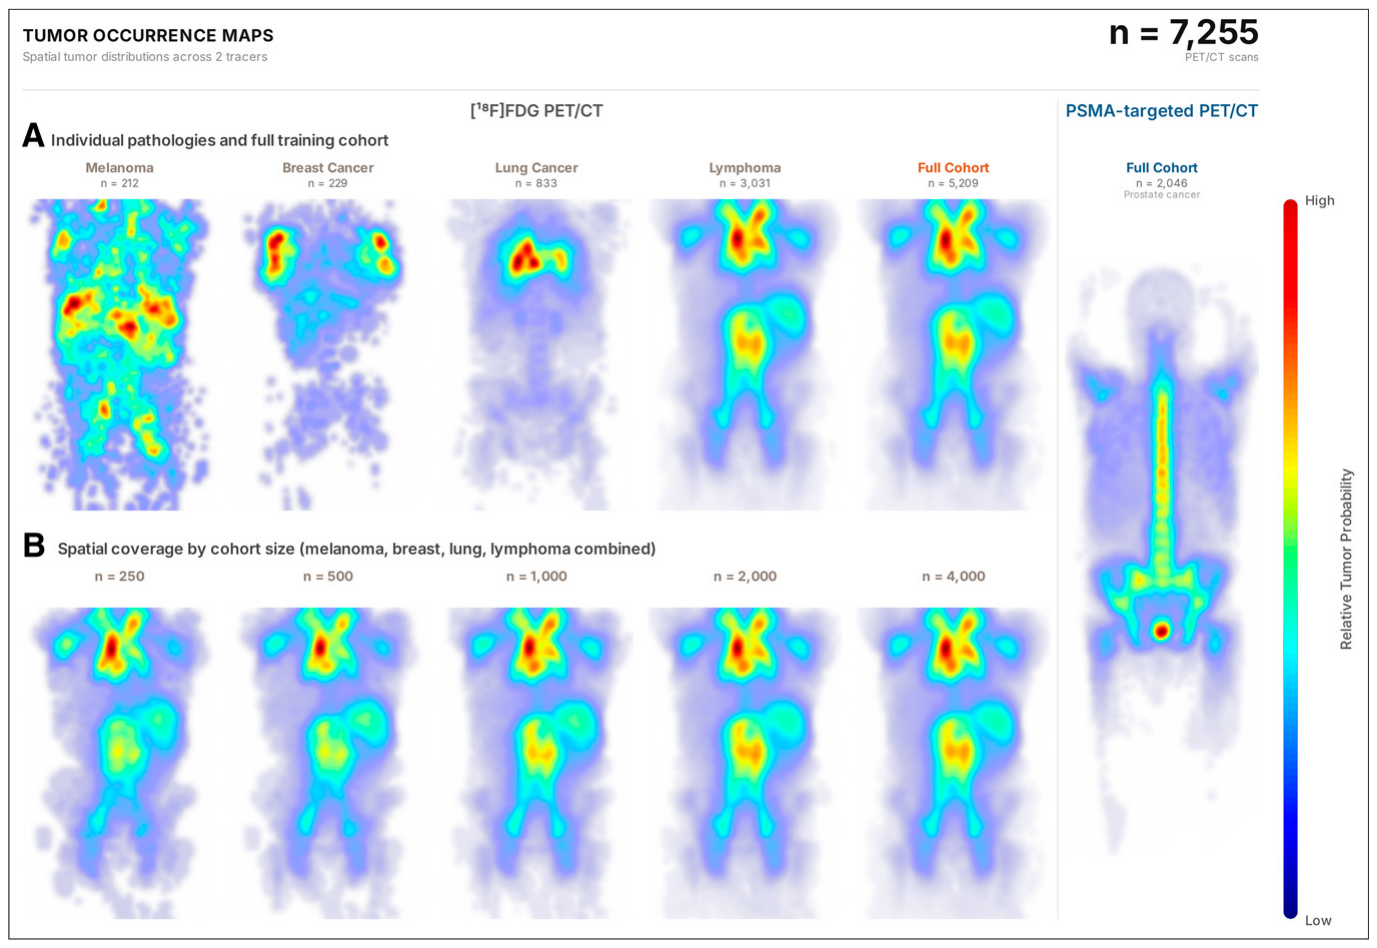
[18F]FDGトレーニングデータから生成されたTOMsは、がんの種類によって腫瘍の空間分布が大きく異なることを示しました。例えば、リンパ腫では体積の28%、メラノーマでは22%の空間的カバレッジがありました (
A)。
この研究では、様々なトレーニングデータ構成(特定の疾患に特化したモデルと、複数の疾患を混ぜた混合モデル)でモデルを訓練し、その性能を比較しました。結果として、TOMsによって定量化された空間的多様性が、ホールドアウトDice係数と強く相関していることが示されました(スピアマンの順位相関係数 ρ = 0.80, P = 0.003) ((図1)B)。
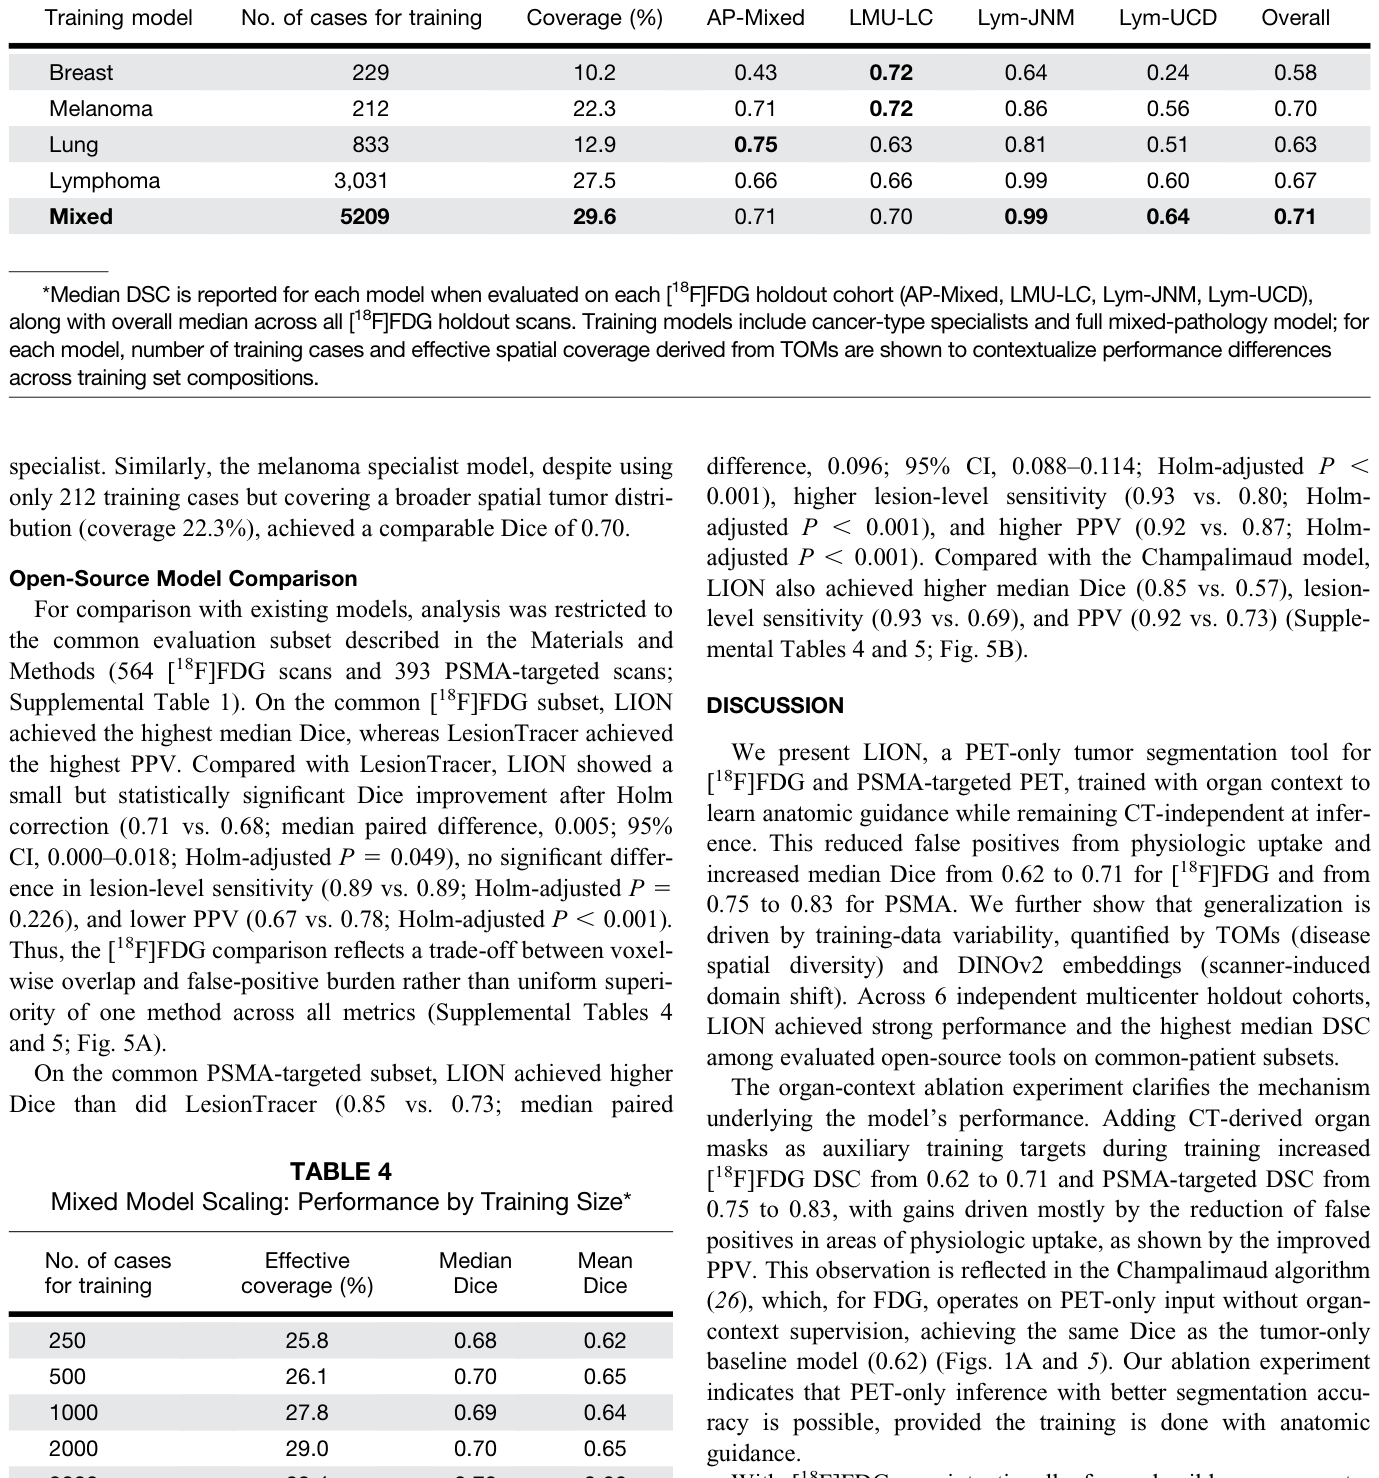
注目すべきは、500件の症例でトレーニングされた混合疾患モデルが、3031件のリンパ腫専門モデルと同等以上のDice係数0.70を達成したことです (
,
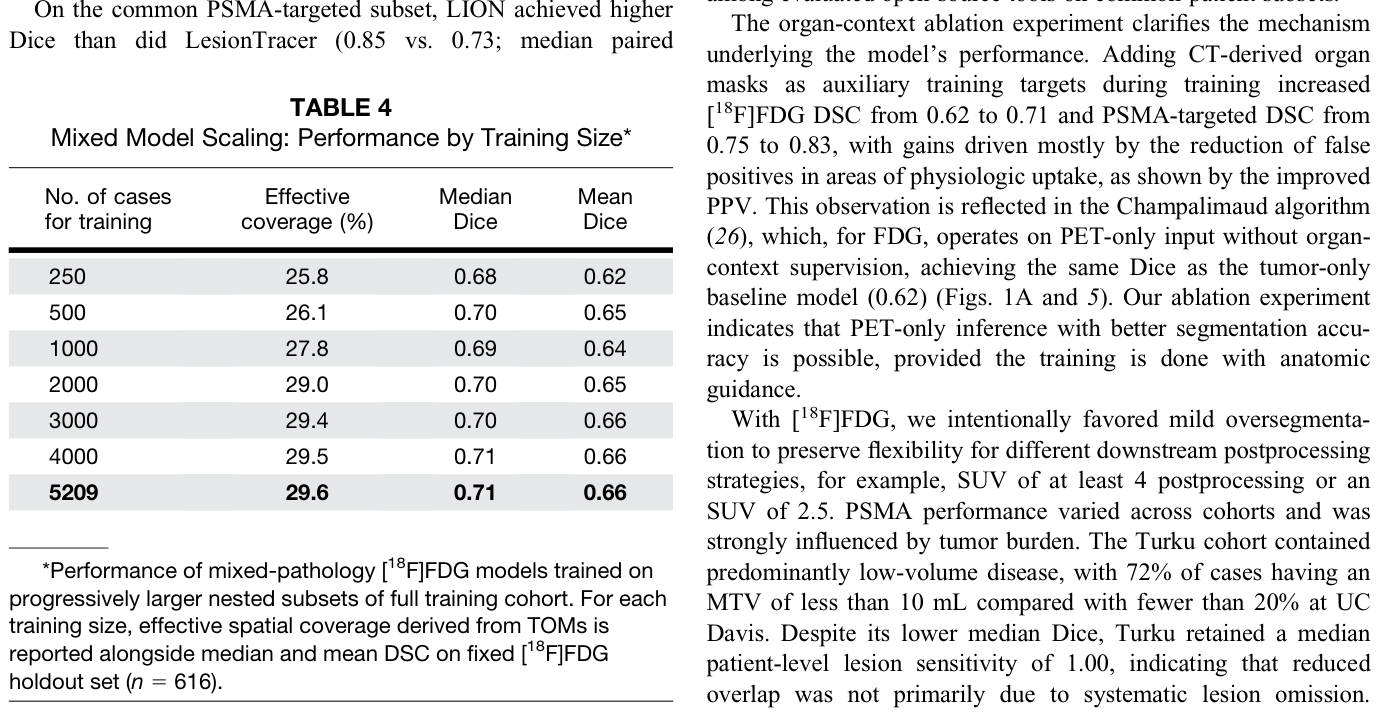
, (図1)C, D)。これは、単一の疾患タイプで症例数を増やすよりも、多様な疾患タイプにわたって空間的な多様性を高めることが、モデルの汎化性能を向上させる上でより効果的であることを示唆しています。例えば、メラノーマ専門モデルはわずか212症例で、より大きな肺がん専門モデル(833症例)よりも高いDice係数0.70を達成しました。これは、メラノーマがより広範な空間的腫瘍分布を持っているためと考えられます。新たなPETトレーサーを用いた腫瘍セグメンテーションモデルを開発する際、少数の症例でも幅広い種類のがんを網羅するデータセットを構築することが重要であると言えるでしょう。
既存のオープンソースモデルとの比較と研究の限界
LIONは、他の3つのオープンソースのPETセグメンテーションモデル(LesionTracer、Champalimaud、TMTV-Net)と比較されました。データ漏洩を防ぐため、特定のホールドアウトコホートを除外した共通の評価データセット([18F]FDGは564件、PSMAは393件)で比較が行われました。
[18F]FDGのセグメンテーションでは、LIONは他のモデルの中で最も高い中央値Dice係数0.71を達成しました。LesionTracerと比較すると、LIONは統計的に有意に高いDice係数を示しましたが、LesionTracerはPPVでLIONを上回りました。これは、LIONがわずかに過剰なセグメンテーションを行うことで感度を維持し、下流の様々な後処理戦略に柔軟性を持たせているためと考えられます (
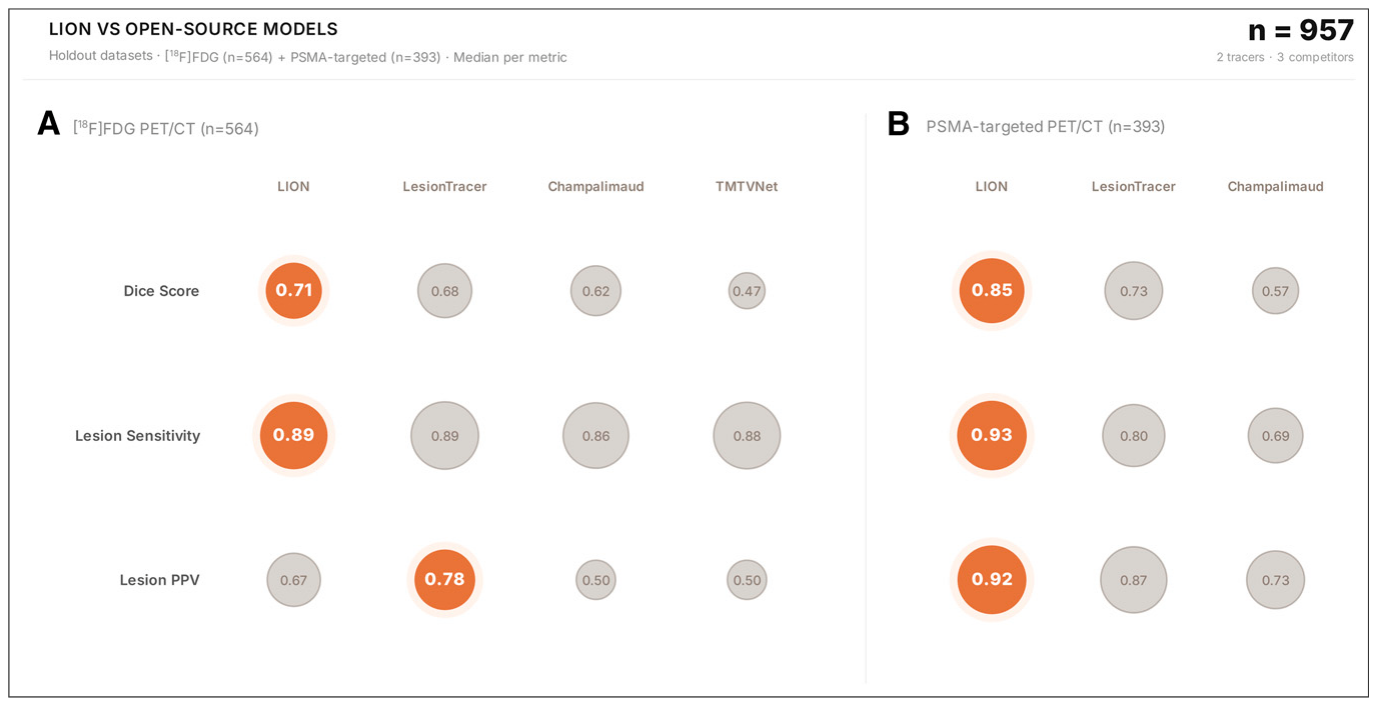
A)。
PSMA標的セグメンテーションでは、LIONはDice係数0.85、感度0.93、PPV 0.92を達成し、LesionTracer(Dice係数0.73)とChampalimaudモデル(Dice係数0.57)の両方を大きく上回る性能を示しました ((図5)B)。
研究の限界
本研究にはいくつかの限界点があります。まず、専門家間の意見の一致度(inter-reader agreement)を評価するための体系的なダブルリードサブセットが利用できませんでした。そのため、各トレーサーの性能の上限を確立できませんでした。第二に、[18F]FDGのトレーニングデータはリンパ腫の症例が多かったため、モデルがそれに偏る可能性があります。また、[18F]FDGモデルは炎症性または治療関連の集積を真の腫瘍と区別する能力が限られています。第三に、PSMA標的セグメンテーションの性能は、非常に小さな腫瘍量の場合に低下する傾向があり、これは前立腺がんの臨床的に重要な意思決定閾値に対応する可能性があります。第四に、TOMs分析で観察された空間的カバレッジとセグメンテーション性能の関連性は、観察的なものであり因果関係を確立するものではありません。また、カバレッジ指標は、性能を向上させるためにどれだけの追加症例やどの疾患が必要かを示すものではありません。最後に、LIONは現在、不確実性推定を提供していないため、展開時に信頼できない予測を特定する能力が限られています。
結論と今後の展望
本研究で開発されたLIONは、CT由来の解剖学的ラベルを用いた臓器コンテキスト監視により、PET画像単独で腫瘍セグメンテーションを可能にし、生理学的集積に起因する偽陽性を効果的に削減します。DINOv2エンベディングはスキャナー関連の変動を特定し、取得プラットフォーム間のドメインシフトを特徴付けます。また、TOMsはPETセグメンテーションデータセットにおける空間的多様性を定量化するための有用なフレームワークを提供します。
最も重要な発見の一つは、トレーニングデータの構成、特にTOMsで定量化される空間的多様性が、セグメンテーション性能と強く関連していることです。大規模な症例数を持つ単一疾患のデータセットよりも、幅広い疾患タイプをカバーする多様なデータセットで学習させることが、より優れた汎化性能につながる可能性が示唆されました。
LIONはオープンソースソフトウェアとして公開されており、今後の前向き検証を支援します。この技術の発展により、手作業でのセグメンテーションというボトルネックが解消され、より効率的で客観的な全身の腫瘍量評価が実現し、がん診療の質がさらに向上することが期待されます。
用語集
- PET/CT: 陽電子放出断層撮影(PET)とコンピューター断層撮影(CT)を組み合わせた画像診断装置。
- [18F]FDG: 多くの癌細胞が活発に取り込むブドウ糖の類似物質で、PET検査で癌の検出に使われる放射性薬剤。
- PSMA (Prostate-Specific Membrane Antigen): 前立腺癌細胞の表面に多く発現するタンパク質で、PSMA標的PET/CTは前立腺癌の診断・治療に用いられる。
- 腫瘍セグメンテーション: 画像の中から腫瘍の領域を自動的または手動で識別し、境界線を特定すること。
- データ中心的深層学習: 深層学習モデルの性能を向上させるために、モデルのアーキテクチャよりもトレーニングデータの品質、多様性、構造に重点を置くアプローチ。
- LION (Lesion Identification in Oncologic Nuclear Imaging): 本研究で開発された、[18F]FDGおよびPSMA標的PET/CT画像専用のオープンソースのPET単独腫瘍セグメンテーションパイプライン。
- Dice係数 (Dice Similarity Coefficient – DSC): 予測されたセグメンテーションと真のセグメンテーションの間の重なり具合を0から1で評価する指標。1に近いほど一致度が高い。
- PPV (Positive Predictive Value): 予測された腫瘍領域のうち、実際に真の腫瘍であった割合。高ければ偽陽性が少ないことを意味する。
- 感度 (Sensitivity): 真の腫瘍病変のうち、モデルが正しく検出できた割合。高ければ偽陰性が少ないことを意味する。
- TOMs (Tumor Occurrence Maps): トレーニングデータセット全体における腫瘍の解剖学的空間内の空間的分布を3次元確率マップとして示すもの。
- DINOv2エンベディング: 自己教師あり学習によって学習された、画像の特徴を捉えるための埋め込み表現。スキャナーによるドメインシフトの分析に用いられる。
- ドメインシフト: トレーニングデータとテストデータの間に存在する、画像取得プロトコルやスキャナーなどに起因する系統的な違い。
- SUV (Standardized Uptake Value): PET画像における放射性薬剤の集積度を示す指標。腫瘍の代謝活性の評価に用いられる。
- nnU-Net: 幅広い医用画像セグメンテーションタスクにおいて高い性能を発揮する、自己設定型の深層学習フレームワーク。
- 補助クラス: モデルが解剖学的コンテキストを学習できるように、腫瘍クラスと合わせてトレーニング中に使用される追加のクラス(例:生理学的集積のある臓器)。
コメントを残す